外形監視とサーバー監視の違いは、どこから、何を観測するかにあります。外形監視はWebサイトの外側からURLへアクセスし、利用者に近い経路で接続や応答の異常を見つけます。サーバー監視はCPU・メモリ・ディスク・プロセス・ログなど、サーバーやアプリケーションの内部情報を確認し、負荷の高まりや不具合の原因を調べるために役立ちます。
結論からいうと、公開Webサイトが利用できるかを知りたいなら外形監視が基本、なぜ問題が起きたかを調べたいならサーバー監視が重要です。どちらか一方が万能なのではなく、外形監視で「利用者側への影響」を見て、サーバー監視で「内部の状態」を確かめると、確認できる範囲が広がります。
本記事では両者を比較表と構成図で整理し、「サーバーは正常なのにサイトが開けない」「CPUは高いのに利用者には問題が出ていない」といったケースを具体的に読み解きます。専門のインフラ担当者がいない中小企業、複数サイトを保守する制作会社、クラウドやレンタルサーバーを運用する担当者が、必要な監視の組み合わせを決められる構成です。
なお、死活監視の仕組みやHTTP監視とPING監視の違いは既存記事で詳しく説明しています。ここでは監視プロトコルの比較を繰り返さず、外側と内側の観測の違いに絞ります。
外形監視とサーバー監視の違いを構成図で理解する
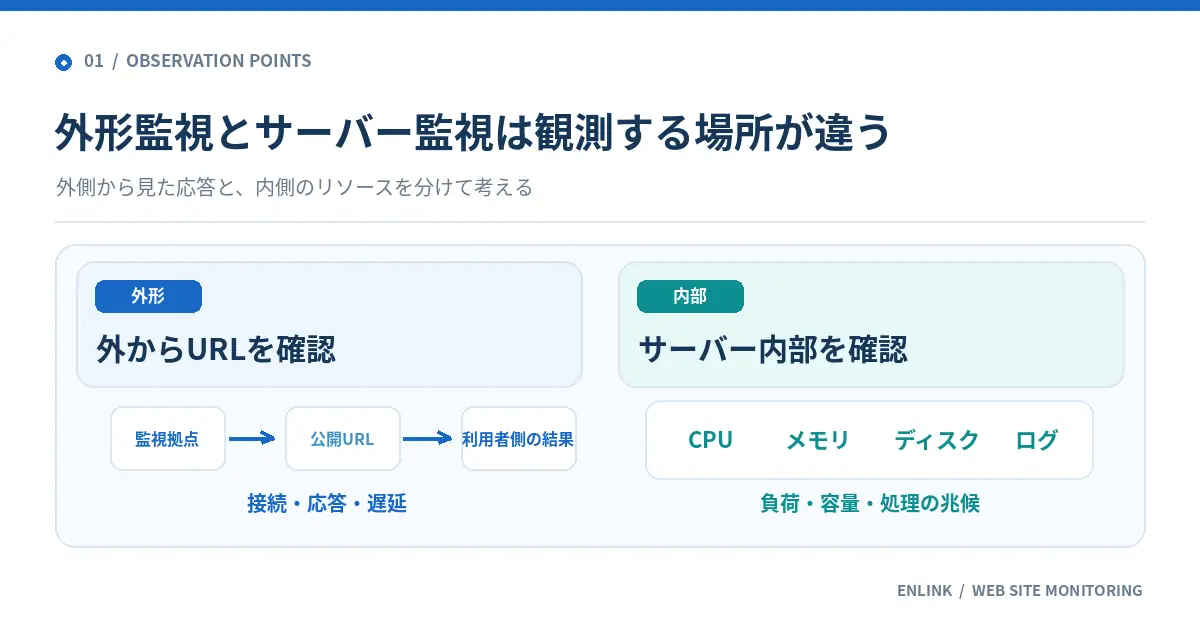
外形監視ではWebサイトの外にある監視拠点が、公開URLなどへリクエストを送ります。一方、サーバー監視はサーバー自身やクラウドの監視基盤からリソースや稼働情報を収集します。二つの監視が見ているのは、同じシステムの別の側面です。
外形監視は利用者に近い場所から確認する
外形監視は英語で「外から中を見る」ブラックボックス監視、または合成監視(Synthetic Monitoring)の一種として説明されることがあります。監視拠点から公開Webサイトへ接続し、応答の有無、結果の判定、応答に要した時間、設定によってはレスポンス本文の内容などを確認します。サーバーの管理者権限がなくても、外部からアクセス可能なURLであれば調べられるのが利点です。
たとえばWebサーバーのプロセスが動いていても、DNSの名前解決、ネットワーク、ロードバランサー、CDN、アプリケーションなど、途中のどこかで問題が起きれば、外部からのアクセスは失敗することがあります。外形監視なら、監視地点から見た接続失敗を記録できます。ただし、失敗の原因がどの装置にあるかまで自動で特定できるとは限りません。
外形監視の「外」とは観測の視点を表します。クラウドの外部監視サービスが公開URLへアクセスする場合のほか、社内の別ネットワークから検査する構成もあります。利用者のいる地域や回線と監視地点が異なれば、結果が必ず一致するわけではない点も理解しておきましょう。
サーバー監視は内部の資源と処理状態を確認する
サーバー監視は、CPU使用率、利用可能メモリ、ディスク空き容量、ディスクI/O、プロセス数、ネットワークトラフィックなどを収集する監視です。エージェントをOSに導入して取得する方式のほか、クラウド事業者が公開するメトリクスやログを利用する方式もあります。実際に取得できる項目は契約プランや環境によって異なります。
たとえばディスク容量が少なくなっている、メモリを使い切りかけている、アプリケーションのエラーログが増えている、といった兆候を、利用者がサイトを開けなくなる前に見つけられる可能性があります。一方、サーバー内部のCPUが正常範囲でも、公開ドメインの設定ミスでサイトにアクセスできないことはあります。内部が正常だから外部の閲覧も正常、とは言い切れません。
「外形監視=HTTP監視」「サーバー監視=PING監視」ではない
監視の視点と通信方式は別の分類です。外形監視ではHTTP/HTTPSに加え、DNSやTCP接続などを確認する場合があります。PINGが使われることもありますが、PINGは「内部監視」を意味しません。またサーバー監視はPINGの応答だけではなく、OSやアプリケーションの内部メトリクスを扱います。
「外形監視かサーバー監視か」を選ぶ際は、プロトコル名ではなく「利用者から見た正常性が必要か」「内部の原因調査が必要か」で考える方が整理しやすくなります。HTTPの応答が成功しても、フォームや決済が動作するとは限らないため、重要な操作には別途シナリオテストなどが必要になる場合もあります。
比較表で確認する、見える異常と見えない異常
外形監視とサーバー監視で見つけやすい異常を並べると、得意な領域がはっきりします。ただし、下表は一般的な構成を想定した比較であり、すべての製品が表の機能を持つという意味ではありません。外形監視でも高機能なシナリオテストを行うものがあり、内部監視もアプリケーションの計装範囲によって見える内容が変わります。
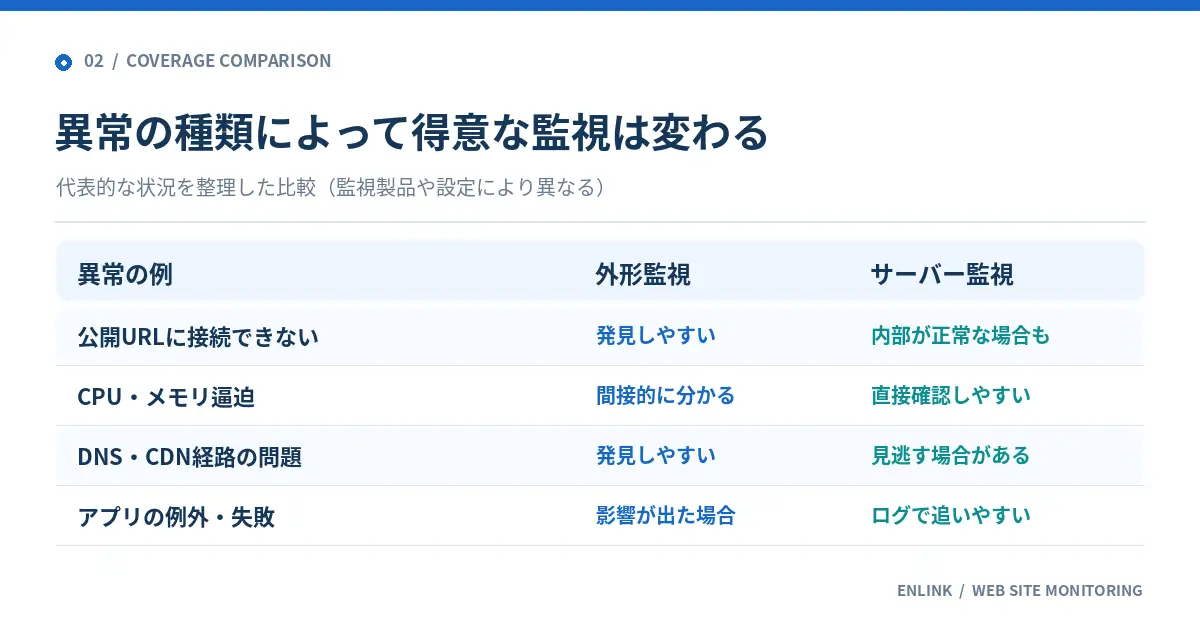
| 確認したい異常 | 外形監視 | サーバー監視 | 判断時の注意点 |
|---|---|---|---|
| 公開URLへの接続失敗 | 得意 | 直接は分からないことがある | 外部経路・DNS・CDNも影響 |
| 外部からの応答遅延 | 得意 | 原因の候補を調べやすい | 通信経路とサーバー負荷を照合 |
| CPU・メモリ逼迫 | 間接的に影響を検知 | 得意 | 負荷が高くても直ちに利用不可とは限らない |
| ディスク容量不足 | 障害発生後に間接検知 | 得意 | 空き容量が小さい段階で対処できる場合がある |
| アプリケーションの例外 | 応答や機能に影響した範囲 | ログを取得すれば調査可能 | ログやAPMの設計が必要 |
| DNSやCDNの外部経路障害 | 気づきやすい | 内部指標だけでは見逃す場合 | 複数地点の確認が役立つ |
| ログイン・決済の動作不良 | 操作テストを組めば検知可能 | エラーや処理状態を追える | 単純なURL応答監視だけでは不足 |
| 利用者ごとの体験差 | 監視地点の範囲内 | 内部だけでは分かりにくい | RUMなど実ユーザーデータも検討 |
外形監視が得意なのは接続経路を含む異常
URLにアクセスできない、想定外のステータスが返る、応答に時間がかかるといった問題は、外側の監視で把握しやすい代表例です。サイトの内部が正常であっても、利用者がアクセスできなければサービスとしては問題があるため、公開サイトの可用性を測る入口に向いています。
ただし、外形監視で「応答あり」と判定したURL以外のページや、会員ログイン後の処理まで確認できるとは限りません。監視対象URLと成功条件を明示し、主要機能の動作確認が必要なら追加のテストを用意します。トップページだけのチェックから「サイト全体に不具合なし」と結論づけるのは避けましょう。
サーバー監視が得意なのは負荷と原因の手掛かり
CPUの負荷が高い、メモリの空きが急減している、ストレージの使用率が上がっている、特定プロセスが停止しているといった情報は、内部メトリクスの得意分野です。たとえば書き込み先ディスクの空き容量が減っていれば、サイトがまだ表示できるうちに原因を調べられるかもしれません。
一方で「CPU使用率が高い=障害」「メモリ使用率が低い=正常」と機械的に結論づけるべきではありません。処理の特性や通常時の負荷によって、問題がない範囲は違います。定常時の推移、アプリケーションログ、実際の外部応答を合わせて評価しましょう。
どちらでも確認できない場合があること
外形監視もサーバー監視も、設定されていない対象までは観測できません。たとえば「決済ボタンを押した後、外部決済画面へ進めない」という問題は、トップページのHTTPチェックでもCPU監視でも見つからないことがあります。ブラウザー操作の自動テスト、APIのシナリオ確認、実ユーザー監視などを組み合わせる必要があるケースです。
重要なのは監視項目を増やすこと自体ではなく、事業上の重要な操作をどこまで検査できているかです。まず利用者の行動を整理し、そのうえで外部アクセス、内部資源、アプリケーションの動作確認をそれぞれ割り当てると、監視の抜け漏れを減らせます。
外形監視とサーバー監視の結果が食い違う4つのケース
実際の現場では、外形監視が異常なのに内部メトリクスが正常、または内部に警告が出ていてもサイトは表示できる、といった食い違いが起こります。二つの結果を組み合わせれば、次に調べる場所の優先順位をつけやすくなります。
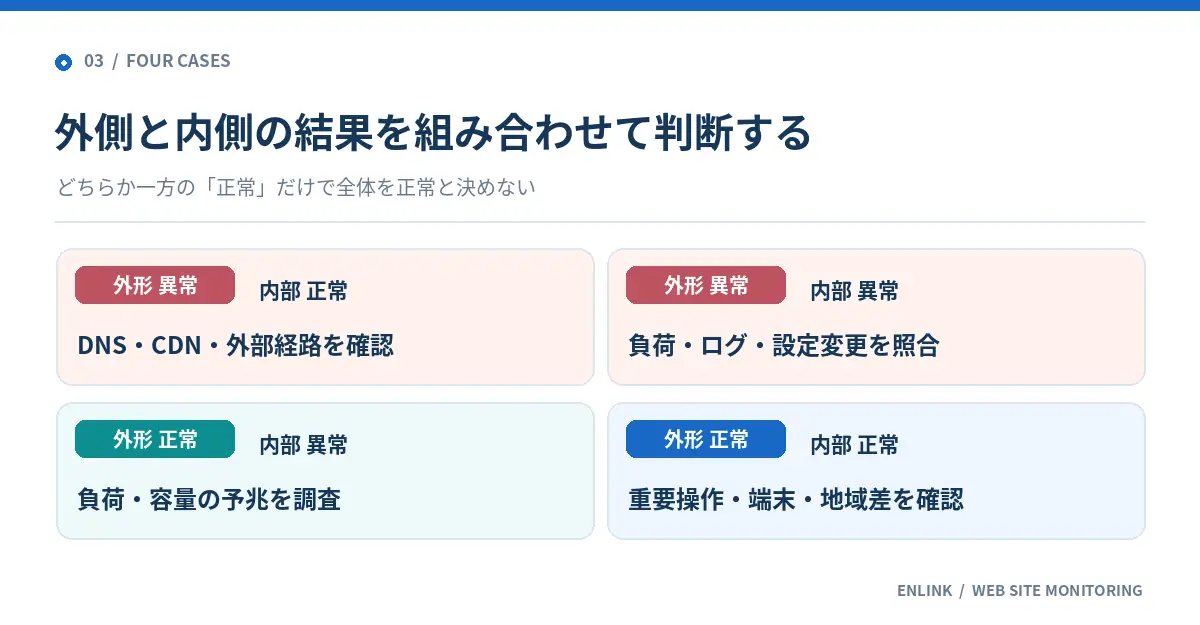
ケース1:外形監視が異常、サーバー指標は正常
公開URLに接続できない一方で、サーバーのCPUやメモリには大きな変化がない状態です。DNSの名前解決、CDN、ロードバランサー、ネットワーク経路、TLS証明書、アクセス制限など、サーバーの外側に近い部分を疑う入口になります。ただしサーバー内部に問題がないと確定したわけではありません。監視していないプロセスやアプリケーション側の不調も考えられます。
まず別の回線や地点から同じURLを確認し、どの経路で失敗するかを整理します。内部メトリクスが正常でも、公開ドメインへの接続確認を後回しにしないことが大切です。利用者からの問い合わせが増えていれば、外部での影響が出ている可能性も高まります。
ケース2:外形監視は正常、サーバー指標に警告
サイトは表示できるものの、CPUが継続して高負荷、ディスク残量が減少、メモリの空きが少ないといった状態です。現在の外形監視では利用不可を観測していなくても、将来の性能低下や書き込み失敗につながる恐れがあります。内部指標を「今の利用者影響がないから無視してよい」と判断しないようにしましょう。
通常時の値と比較し、ピーク時間帯の一時的な負荷か、長時間続く変化かを確認します。プロセス別の使用量やログを見て原因を絞り込み、必要なら容量確保、処理の改善、構成見直しなどを検討します。CPUやメモリの絶対的な閾値は環境ごとに異なるため、記事中に万能な基準値を置きません。
ケース3:外形監視もサーバー監視も異常
公開URLが失敗し、同時刻にサーバーの負荷やエラーログが悪化している場合です。内部処理が外部のアクセス障害につながっている可能性があります。時刻を揃えて、異常がどちらから始まったか、アプリケーションの再起動や設定変更が行われていないかを確認します。
たとえばディスク空き容量が失われ、データベースが書き込めなくなり、最終的にログインやサイト表示が失敗するという連鎖があり得ます。ただし二つの監視が同時に失敗しただけで因果関係は断定できません。OS・Webサーバー・アプリケーションのログ、インフラ変更履歴などを証拠として照合する必要があります。
ケース4:どちらも正常だが利用者から苦情がある
一部のページでJavaScriptエラーが出る、特定のスマートフォンだけで購入ボタンが反応しない、地域やネットワークによってアクセスできない、といった状況では、両方の監視で正常と表示されることがあります。監視範囲に含まれない機能や条件で問題が起きている可能性があります。
この場合は利用者のOS・ブラウザー・操作手順・エラー時刻を確認し、必要に応じて実ユーザー監視、ブラウザーコンソール、セッション単位のログ、合成シナリオテストを検討します。「監視が正常なのだから不具合ではない」と切り捨てないことが、ユーザー目線での運用には欠かせません。
サイトの種類別に考える監視の組み合わせ
すべてのWebサイトに同じ監視設備が必要とは限りません。サイトの用途、運営会社が管理できる範囲、停止した場合の影響に応じて、外形監視を基本にどの内部情報を追加するか考えると、監視のコストと実用性のバランスを取りやすくなります。
企業サイト・小規模ブログでは外形監視を入口にする
企業サイトや小規模なブログでは、サイトが開かなくなっても、毎日手動で確認できるとは限りません。まず代表的な公開URLの外形監視を設定すれば、少なくともそのURLの応答状態を定期的に記録する入口になります。問い合わせフォームなどの重要な機能は、必要に応じて別途動作確認を加えます。
共用レンタルサーバーではCPUや詳細ログの収集権限が制限される場合があります。その場合、無理にエージェントを導入しようとせず、ホスティング事業者の管理画面や公式障害情報を併用します。外形監視だけで原因が分からないときは、発生日時とエラー内容を控えて事業者へ問い合わせできるようにしておくとよいでしょう。
ECサイトや予約サイトでは重要操作も監視する
ECサイトや予約サイトでは、トップページが表示されるだけでは十分とは言えません。商品詳細、カート、購入・予約の確認など、利用者にとって重要な操作が正常に進められるかを確認する必要があります。外形監視のURLチェックと、必要に応じたブラウザー操作テストやAPIのシナリオテストを役割分担させます。
内部側ではデータベース接続、キューの滞留、アプリケーションエラー、CPUやディスクなどを確認し、利用者の操作に影響しそうな兆候を把握します。テスト注文を実行する場合は、実際の売上計上や顧客データに影響しない環境・手順を整え、無断の本番操作をしないようにしましょう。
複数サイトを保守する制作会社では管理単位を統一する
制作会社や保守代行会社では、顧客ごとにサイトの管理先やサーバー契約が異なるため、誰が何を確認するかが曖昧になりやすいのが課題です。外形監視ではサイト名、公開URL、連絡担当者、通知先、異常時の確認手順をそろえると運用しやすくなります。
内部監視を委託先が利用できない場合は、確認権限がある事業者と役割を分担します。外形監視から「このURLに接続できなかった」という事実を示し、内部ログはサーバー管理者が確認する、といった手順にすることで、権限を過度に広げずに協力できます。複数サイトの監視では契約範囲や個人情報へのアクセスも整理しておきましょう。
自社サーバーやクラウドでは内部指標を積極的に組み合わせる
VPSやクラウドの管理権限があり、エージェントやログ収集を安全に導入できるなら、外形監視とサーバー監視を並行して運用する価値が高まります。公開URLが失敗した瞬間のCPU、メモリ、ディスク、プロセス、アプリケーションログなどを確認できれば、対応開始時の情報が増えます。
ただし内部メトリクスは収集するだけで自動的に原因が判明するものではありません。ログの保持期間、時刻の統一、取得対象の選定、閲覧権限、監視基盤そのものの障害を含めて設計することが重要です。担当者が読めない大量のアラートを作るよりも、行動に結びつく項目から始める方が実務的です。
障害が起きたときの切り分け手順
外形監視でエラーが検知されたときは、最初からサーバーの再起動や設定変更に進むのではなく、影響範囲を確かめます。その後、外部経路、サーバー内部、アプリケーションの順で証拠を突き合わせると、不要な操作で状況を悪化させるリスクを抑えられます。
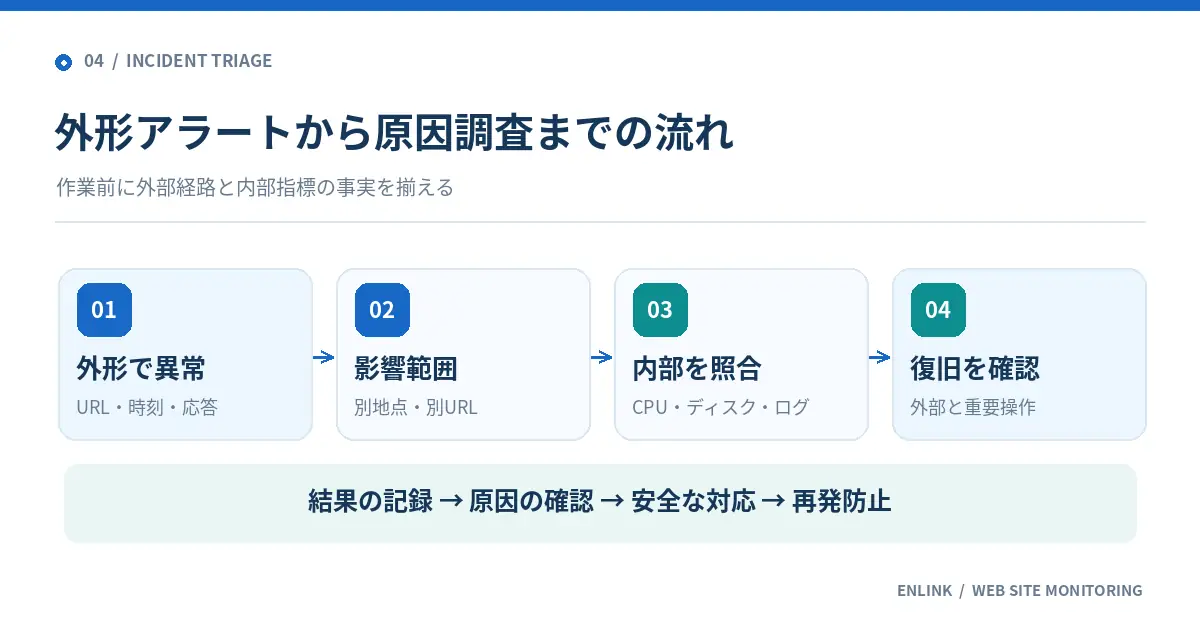
手順1:異常の事実と影響範囲を確認する
監視で失敗した対象URL、時刻、失敗の種類、応答時間の変化を確認します。別の回線やブラウザーから同じURLにアクセスして再現するかも調べます。ただし再確認時に正常になっていても、先ほどの一時的な障害がなかったとは言い切れません。初回の記録を保持しておきます。
他のページも開けないのか、特定のドメインだけか、ログインした後だけかを整理します。複数のサイトで同時に失敗しているなら、共通のDNS設定やホスティング、通信経路の影響も考えられます。事実と推測を分け、利用者への案内が必要な状況か判断しましょう。
手順2:外部経路と内部メトリクスを同じ時刻で照合する
外形監視が失敗した時刻の前後で、サーバー側のCPU、利用可能メモリ、ディスク、ネットワーク、Webサーバーとアプリケーションのログを確認します。内部指標に問題が見当たらない場合は、DNS、CDN、ロードバランサー、TLS、アクセス制御などの確認へ進みます。いずれか一つの正常値だけで原因を除外しないことが大切です。
監視ツールとサーバーでタイムゾーンが違うと、同じ障害の記録を突き合わせられなくなります。報告書ではJSTかUTCかを明示し、必要に応じて秒単位の誤差も考慮します。ログが保存されていない場合は、確認できなかった項目を記録して次の監視改善に反映します。
手順3:安全な復旧と再発防止につなげる
原因の候補が絞れたら、作業権限と影響範囲を確認し、承認された復旧手順に沿って対応します。やみくもな再起動は、残っていた調査用の記録を失ったり、別の障害を生む可能性があります。変更前に時刻と内容を控え、必要なバックアップや切り戻し方法を確認してください。
復旧した後は、外部からのアクセスが実際に回復したか、内部の警告が解消したか、重要な操作に支障がないかをそれぞれ確認します。サーバー内部のメトリクスが改善しても、外部の利用者がまだアクセスできない場合は復旧完了と判断しません。障害後に「どの監視が最初に兆候を捉えたか」を振り返ると、検知方法の改善にもつながります。
外形監視と内部監視を組み合わせる設計例
監視の組み合わせを考える際は、まず公開サイトへの外部チェックを置き、次に管理可能な範囲の内部指標を追加し、最後に重要なユーザー操作を補います。すべてを一度に導入せず、観測できる項目を明示することで、費用と運用負担を抑えながら監視範囲を広げられます。
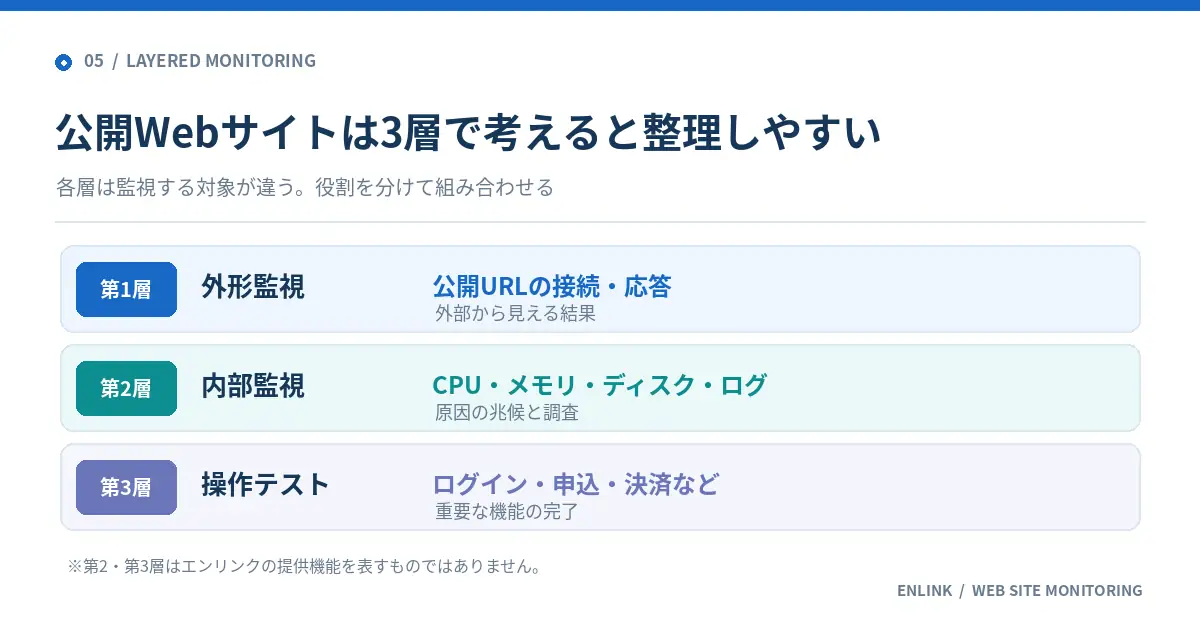
第1層:公開URLの応答を外側から確認する
最初の層は、代表的な公開URLの到達性と応答結果を確認する外形監視です。どのURLを選ぶかはサイトの用途で異なります。トップページが正常でも申し込みページに問題があるサイトなら、重要なページの確認方法を別途検討します。監視地点や間隔によって短時間の異常を取りこぼす可能性があることも明示します。
外部から観測した失敗は「監視拠点から指定URLへ正常に接続できなかった」という事実を示します。原因の断定とは分けて扱い、必要に応じて別地点から再確認します。最初から監視対象を大量に登録するのではなく、利用者への影響が大きい順に追加すると設計しやすくなります。
第2層:CPU・メモリ・ディスク・ログを内部で確認する
自社で管理できるサーバーでは、外形監視が失敗したときに内部を調べられるよう、メトリクスやログ収集を整えます。CPUやメモリの使用量だけでなく、ディスク容量、I/Oの遅延、プロセスの稼働、アプリケーションの例外などを必要な範囲で記録します。障害前後の推移を比較できるよう保持期間を設計することが重要です。
レンタルサーバーや委託先の環境では、取得可能な内部データに制約があります。外部の監視サービスがCPUやデータベース内部を読めると誤解しないようにし、管理画面で提供される項目と追加で必要な権限を確認しましょう。機密情報を含むログは、閲覧者と保存先の制限も必要です。
第3層:利用者の重要な操作が完了するかを確認する
ログイン、予約、決済、問い合わせ送信などを提供するサービスでは、URLの応答と内部資源だけでなく、ユーザーの目的が達成できるかを検査します。これには操作シナリオの自動テストや、実際の利用者の動作データを確認する方法があります。対象機能の重要度に応じて選びます。
外形監視での合成テストと、実ユーザー監視(RUM)は別の概念です。合成テストは決めた条件で定期実行しますが、RUMは実際の利用者から収集できた経験を扱います。利用者がいない時間でも合成テストは動かせる一方、合成テストだけでは全ての端末・地域・操作を代表できません。両者の役割も区別しておくとよいでしょう。
通知は検知と原因調査を分けて整理する
外部チェックの失敗では「どのサイトに利用者影響が出ている可能性があるか」、内部監視の警告では「どのサーバー・どの項目が通常と違うか」を伝えるようにすると、通知の意味が明確になります。複数のツールから同じ障害について何十件も通知が出る構成は、判断を妨げるおそれがあります。
通知条件、再確認の回数、担当者、夜間の連絡ルール、計画メンテナンス時の扱いを決め、必要に応じてまとめます。設定値はサイトによって適切なものが異なるため、万能な数値を一律に当てはめません。通知を受けた人が次に何を調べればよいかを示すことが、実用的な監視設計につながります。
導入前に決めたい監視項目と運用ルール
監視ツールを導入するだけで、サイトの安定稼働が保証されるわけではありません。監視によって確認したい目標を決め、それに合わせて対象URL、担当者、内部の監視項目、確認頻度、記録の扱いを設計する必要があります。
対象URLと監視地点を決める
サイトの代表URLだけでなく、利用者が必ず通る重要なページがあるかを確認します。内部用の管理画面や非公開APIなどは、外部の監視サービスから直接アクセスさせてはいけない場合があります。公開できるURLと権限の必要なURLを区別し、認証情報が必要な監視には安全な仕組みを使ってください。
監視する地域についても、主な利用者が日本なのか海外なのかで優先度が変わります。外部の一地点だけが失敗している場合は、監視地点側の一時的な通信問題も考慮します。ただし複数地点で同時に成功したからといって、世界中の利用者が必ず正常にアクセスできると保証するものではありません。
内部で取得する情報は原因調査から逆算する
CPU使用率、メモリ使用率、ディスク残量、プロセス、アプリケーションログなど、取得できるものを無差別に増やすと運用が複雑になります。「ディスクが満杯になったときに何を止めるか」「データベース接続エラー時にどのログを調べるか」など、想定する問題から逆算して必要な項目を選ぶとよいでしょう。
監視対象のサーバーが複数ある場合は、ホスト名、役割、公開サイトとの対応関係を記録します。ロードバランサーの後ろに複数のサーバーがある構成では、一台の故障がすぐに全体の外形障害につながらないことがあります。この場合、外部の応答確認だけでは個別サーバーの不具合を見逃すことがあります。
誰が障害を確認し、いつ復旧判断をするか決める
監視結果を見ても対応する人がいなければ、障害は解決しません。営業時間内の担当者、夜間休日の連絡方法、サーバー管理者へのエスカレーション、復旧の確認方法を明確にします。制作会社と発注元、レンタルサーバー事業者などが関わるときは、障害対応の責任範囲を事前に整理しておきます。
復旧判断では「内部ログが落ち着いた」「サービスが外部から利用できる」「主要な業務処理が完了する」という別々の確認点を持つことが有効です。すべてが必要とは限りませんが、少なくとも何を確認して復旧と呼んだかは記録しておきましょう。
外形監視だけ、サーバー監視だけで運用する際の注意点
どちらか片方だけで運用する場合、見えない部分を理解したうえで補助的な確認手順を用意することが重要です。ツールの多機能さよりも、運用している人が検知結果の意味と限界を説明できることを優先しましょう。
外形監視だけでは根本原因が特定できない
外形監視でサイトが開けないことを確認できても、その原因がCPU負荷なのかDNS設定なのか、アプリケーションの例外なのかまでは分からない場合があります。サーバーの内部情報へアクセスする権限がない場合、原因調査には管理会社の協力が必要です。
特に監視の判定が成功していても、特定の操作に問題がある場合は見逃しが起こり得ます。「監視結果が正常=全機能が正常」と説明しないようにして、必要な手動確認やシナリオテストを補います。
サーバー監視だけでは利用者側の接続失敗を見逃す
サーバーが正常な負荷で動いていても、DNSの誤設定やCDNの不具合などがあれば、外部からサイトを開けない場合があります。内部メトリクスが正常なことを理由に利用者の報告を否定してはいけません。外部の公開URLに実際にアクセスする確認を組み合わせます。
サーバー監視システムがサーバー自身と同じ障害の影響を受ければ、監視結果が届かなくなることもあります。監視データが届かない状態は「正常値」とは異なります。観測基盤の停止や欠測を区別する設計が必要です。
監視間隔と成功率の数値を誤解しない
5分ごとの外形監視で失敗が一回あっても、実際の停止時間が正確に5分だったとは限りません。同じくチェックがすべて成功したからといって、監視と監視の間に短時間の障害がなかったとは証明できません。内部メトリクスも収集間隔の間の瞬間的な変化を捉えられない場合があります。
時間ベースの稼働率の計算と、一定間隔で取得したチェックの成功率は、指標の意味が異なります。数値を対外的に示すときは、Webサイトの稼働率の計算方法と99.9%の停止時間も参考にし、計算期間と観測方法を併記してください。
エンリンクでできる外形監視とサーバー監視の範囲
エンリンクは、Webサイトの公開URLを登録してHTTP/HTTPSの応答状態などを確認できるサービスです。一方、一般的なサーバー監視に含まれるCPU・メモリ・ディスクの内部指標をすべて収集できるものではありません。提供中の機能と役割を正しく把握したうえで、必要な内部監視を別途組み合わせるのが現実的です。
エンリンクの外形監視で確認できること
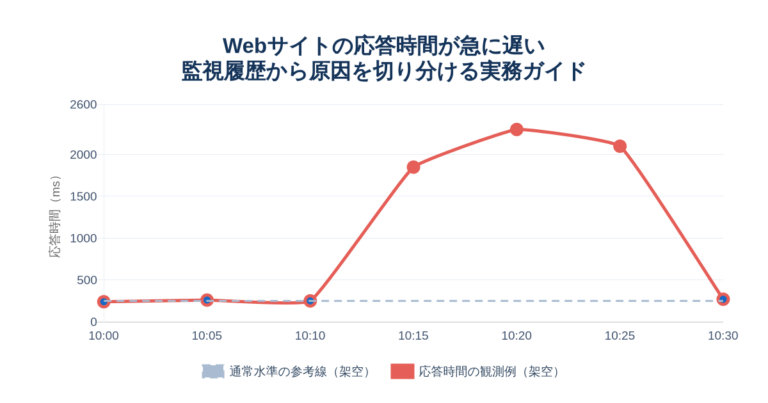
登録したWebサイトに対するHTTP/HTTPSの定期チェック、HTTPステータスコード、応答時間、チェック履歴などを管理画面から確認できます。取得された結果を見て、指定URLが外部からどう応答していたか、以前と比べて応答時間に変化がないかを振り返ることができます。
ただし外形監視は、外部から観測された結果です。HTTPで正常応答が確認できても、実際の問い合わせ送信や決済処理が必ず正常であると保証するものではありません。また、エンリンクがVPSのCPU・メモリや内部ログを直接取得する機能を提供していると説明してはいけません。現在の機能範囲はエンリンクの機能一覧で確認できます。
無料プランと有料プランで選べる間隔
エンリンクの無料プランでは最大5サイトを登録でき、定期監視は1日2回です。有料プランでは契約内容に応じて最短15分・5分・1分の監視間隔を選べます。これらは設定できる最短の定期監視間隔を示すものであり、実際の実行時刻や障害検知までの時間を保証する数字ではありません。
監視頻度や登録できるサイト数、最新の料金は料金プランを確認してください。まず公開サイトの外側からの応答を把握したい場合は、無料でアカウントを登録し、実際の記録の見え方を確かめられます。内部のサーバー状態も必要なら、ホスティング事業者やクラウドの監視サービスを別途検討します。
原因調査のために別途用意したい情報
エンリンクなどの外形監視でエラーを確認した後、原因を追うためには、サーバーのログ、CPU・メモリ・ディスクの推移、アプリケーションのエラー記録、設定変更履歴などが役立ちます。これらはWebサイトの契約・管理方法によって取得できる範囲が異なります。
たとえばクラウドで運用する場合は、クラウド側のメトリクスやログ収集を利用する方法があります。AWSのCloudWatchエージェントは設定によりCPU、メモリ、ディスクなどのメトリクスを収集でき、Google Cloudの監視機能は外部の公開URLへ定期的な稼働チェックを行えます。両者のような異なる観測手段を、目的と権限に応じて組み合わせることが監視設計の基本です。
外形監視とサーバー監視についてよくある質問
導入を検討するときに混同しやすいポイントを、監視の目的と利用できる情報の違いから簡潔に整理します。判断に迷った場合は、まず実際に確認したい障害を一つ選び、どちらの情報が必要か考えてみましょう。
外形監視と死活監視は同じ意味ですか?
完全に同じではありません。死活監視は対象が応答しているかを確認する監視の総称として使われることがあり、外形監視は対象の外側から観測する視点を強調した呼び方です。外形監視では単純な稼働確認に加え、応答時間や必要に応じたコンテンツ確認を扱う場合もあります。
サーバー監視があれば外形監視は不要ですか?
不要とは言えません。サーバー内部の状態が正常でも、DNS・CDN・ネットワークなどの原因で外部からアクセスできないことがあります。公開サイトで利用者の接続可否を把握したい場合は、外部からの確認を組み合わせる意義があります。
外形監視があればCPUやディスクを監視しなくてもよいですか?
外形監視だけでは内部の負荷や残容量を把握できないため、原因の調査や予防には限界があります。サーバーの管理権限があり、負荷・容量の管理責任を持つ場合は、必要な内部メトリクスを追加することをおすすめします。共用サーバーなどで取得できない場合は、事業者の管理画面やサポート情報も活用します。
外形監視はブラウザーの表示崩れも検知できますか?
単純なURLの応答確認だけでは、レイアウト崩れやJavaScriptの操作不良を検知できない場合があります。一方、ブラウザーを使った合成テストでは、設定次第で画面操作や表示内容を検査できる製品もあります。どこまで確認できるかは監視方式と設定によって異なります。
外形監視だけで障害の原因を特定できますか?
原因の手掛かりは得られますが、確定できるとは限りません。外形監視でDNSエラーやタイムアウトなどの種類が分かっても、サーバー側やネットワーク側の記録を突き合わせる必要がある場合があります。結論はログや設定変更履歴など、追加の証拠を確認してから判断しましょう。
レンタルサーバーでも外形監視を利用できますか?
公開されているWebサイトに対し、必要なアクセス権限と利用条件が整っていれば、サーバーへエージェントを導入せずに外形監視を行える場合があります。サイトの所有者や管理者の許可を得て、監視対象URLとアクセス頻度を適切に設定してください。内部メトリクスが必要な場合は契約先の提供範囲を確認します。
最初にどちらの監視から始めるべきですか?
公開サイトの利用可否が気になるなら外形監視から始め、内部の負荷や容量を管理する責任があるならサーバー監視も併用するのが分かりやすい方法です。多くのサイトでは両者は競合ではなく補完関係です。重要な機能がある場合は、必要に応じて操作テストも加えます。
まとめ:利用者から見た異常と内部の原因を分けて監視する
外形監視とサーバー監視は、役割が異なります。外形監視は「利用者に近い場所から指定URLが利用できるか」、サーバー監視は「内部のCPU・メモリ・ディスク・処理やログに問題がないか」を確認するためのものです。両者を併用すれば、異常の発見と原因の調査をつなげやすくなります。
外形監視が異常でも内部が正常なことはあり、逆に内部に警告が出ていても外部からは正常に利用できることがあります。二つの結果が一致しない場合こそ、監視の失敗ではなく、どの経路・どの処理を次に調べるべきか判断する材料として活用してください。監視が正常でも重要な操作に不具合が起きる場合があるため、観測範囲の限界も説明することが大切です。
公開Webサイトの外部からの状態を確認したい場合は、エンリンクの無料プランで最大5サイトから始められます。CPU・メモリなどの内部監視が必要なら別の管理手段を組み合わせ、確認できる範囲を明確にして運用しましょう。
参照した公式資料:Grafana公式「Synthetic Monitoring Introduction」、Google Cloud公式「Public uptime checks」、AWS公式「CloudWatch Synthetics」、AWS公式「CloudWatchエージェントのメトリクス」。参照日:2026年10月23日。