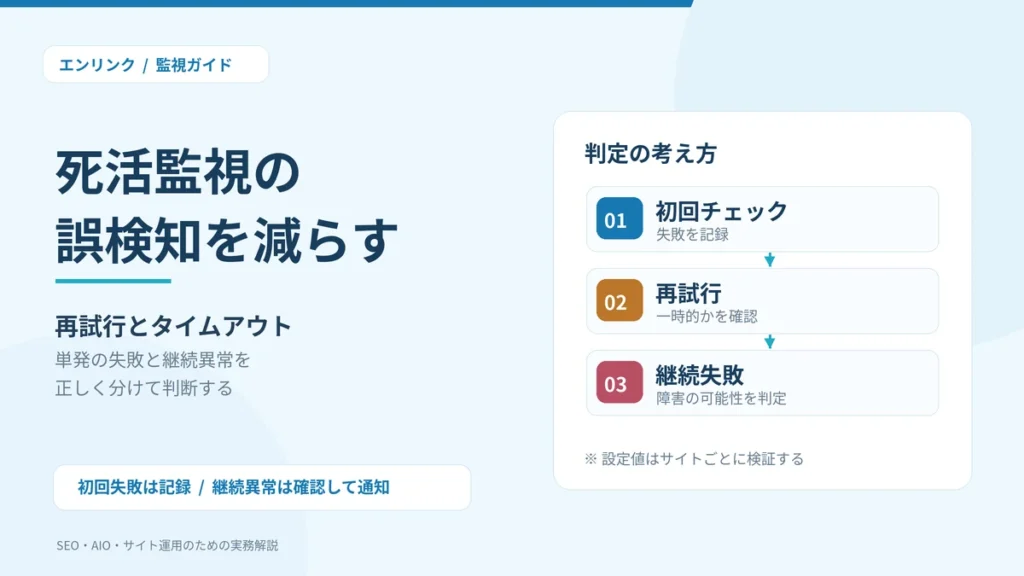
死活監視で「サイトが停止した」という警告が出たのに、すぐ確認すると正常に開けることがあります。こうした通知が続くと、担当者は確認に追われ、本当に対応すべき障害まで見逃しかねません。対策の中心は、1回の失敗をそのまま障害確定とせず、再試行・タイムアウト・連続失敗の判定を適切に組み合わせることです。
例えば「最初のHTTPチェックが失敗したら1回だけ再試行し、両方失敗した検査サイクルが2回続いた場合に障害の可能性を通知する」という構成が考えられます。ただし、これは仕組みを理解するための設定例であり、全サイト共通の推奨値ではありません。確認を厳しくするほど単発の失敗は通知されにくくなりますが、本当の停止を知らせる時刻も遅くなる場合があります。
この記事では、監視結果の「失敗」と「誤検知」を区別し、具体的な判定フロー、秒数や回数の考え方、3つの設定例、ログからの見直し手順を解説します。対象は企業サイト・ECサイト・Web制作会社などの運営担当者です。死活監視の仕組みやHTTP・PING監視の違いは既存の記事に集約し、ここでは失敗をどう判断するかに集中します。
死活監視の「誤検知」はなぜ発生する?
監視に失敗したという記録は、必ずしもWebサイト全体が停止した証拠ではありません。監視地点の通信経路、サイトの瞬間的な応答遅延、セキュリティ設定など、さまざまな条件によって失敗するためです。一方で短時間でも実際に停止していた可能性はあるので、安易に「誤検知だった」と断定しないことも重要です。
「1回のチェック失敗」と「実際のサイト障害」は違う
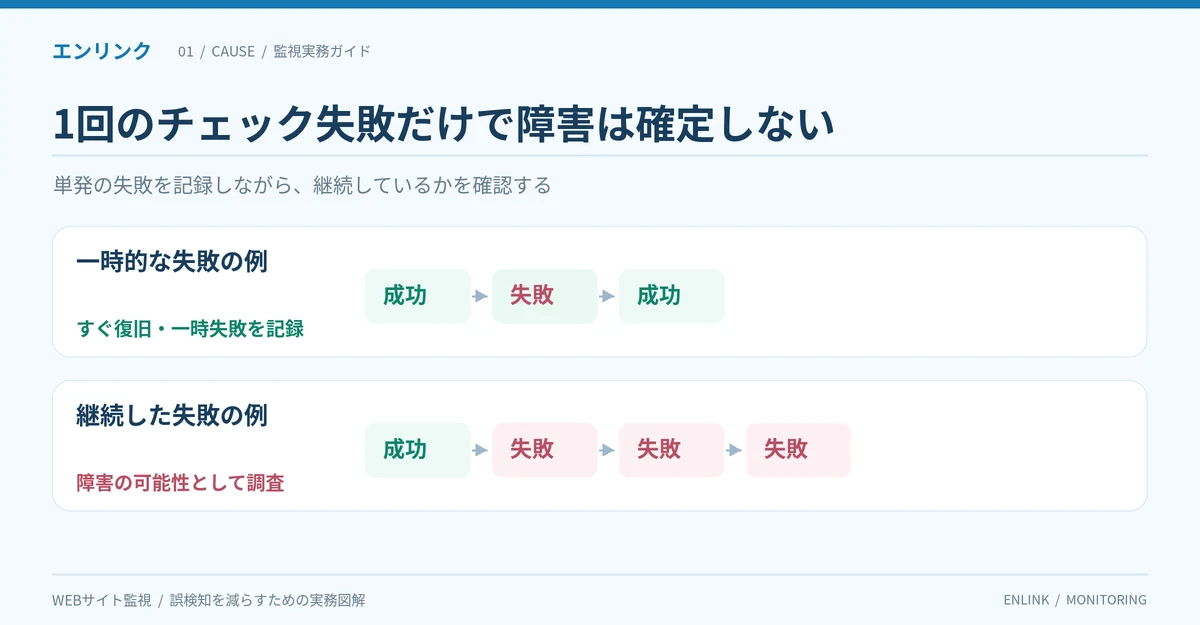
監視の1回のHTTPリクエストで接続できなかった場合、確実に言えるのは「その時刻に、その監視地点・設定でチェックが失敗した」ということです。サイトのDNSが解決できなかった、TCP接続できなかった、設定した秒数までに応答がなかったなど、失敗した段階も複数あります。利用者全員が同じ問題を経験したかどうかは別に確認する必要があります。
反対に、監視が次回のチェックで成功したからといって、直前の失敗が誤検知だったとも限りません。20秒だけ実際にサイトが停止して復旧した可能性もあります。監視ログを「成功」「失敗」の二値だけで見るのではなく、時刻、応答コード、エラー種別、監視地点と利用者への影響を照合しましょう。
誤検知と判断しやすい代表的な状況
監視地点側の一時的なネットワーク混雑やDNS解決失敗、短い応答遅延、WAFによる監視アクセスだけの拒否などは、監視結果と一般利用者の状態が食い違う原因になり得ます。定期作業で一時的にアクセスを制限している時間や、監視用URLが変更されたままの場合も、不要な警告が増えることがあります。
原因が分からないときに全てを「通信の瞬断」と片づけるのは危険です。実際の障害を見逃す可能性があるため、同時刻のサーバーログ、別の地点からの到達可否、変更履歴なども確認します。あくまで一時的なチェック失敗を確認すべき事象として扱い、即座の障害確定と分ける考え方が基本です。
誤検知が多すぎると本当のアラートが埋もれる
失敗のたびに何度も通知を受ける運用では、担当者がアラートを見ること自体を負担に感じるようになります。GoogleのSRE資料でも、緊急通知は実際に対応すべき利用者影響を中心に設計し、ノイズの多いアラートを避ける重要性が説明されています。
ただし「通知を減らす」ことを唯一の目的にしてはいけません。検知が遅れれば障害の復旧も遅れます。必要なのは、単発の失敗を記録として残しながら、対応が必要な継続異常を見分けることです。ログを消すのではなく、警告の扱いを段階的にすると改善につながります。
再試行・タイムアウト・連続失敗を区別する
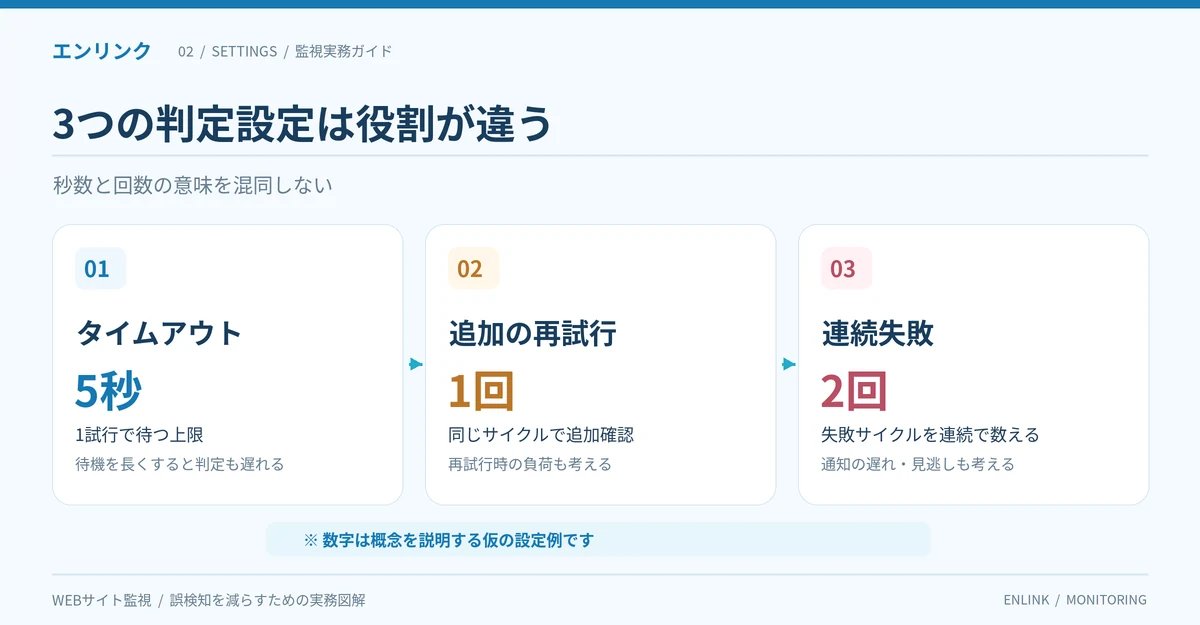
誤検知対策で混同しやすいのが「何秒待つか」「何回やり直すか」「何回続いたら障害扱いにするか」です。この3つは異なる設定です。意味を分けておかないと、失敗の判定時刻や通知までの時間を正しく見積もれません。
| 判定の要素 | 主な役割 | 例 | 大きくしすぎたときの注意 |
|---|---|---|---|
| タイムアウト | 1回の試行で応答を待つ上限 | 全体で5秒待つ | 失敗の確定が遅くなる |
| 再試行 | 失敗直後に追加で確認する | 失敗時だけ1回再試行 | 負荷や判定時間が増える |
| 連続失敗しきい値 | 複数の検査サイクルを通じて継続異常を判定 | 失敗したサイクルが2回続く | 短い実障害を通知しないことがある |
| 復旧判定 | 異常から正常へ戻す基準 | 正常なサイクルが2回続く | 復旧表示が遅くなる |
タイムアウトは1回のチェックの待機上限
タイムアウトは「応答がない状態を何秒まで待つか」という上限です。例えば全体タイムアウトを5秒に設定した場合、監視ツールが規定した範囲内で応答が完了しなければ失敗として扱います。ただしDNS解決、接続、TLS、最初の応答、本文の取得など、どこまでが時間計測の対象かは製品によって違います。
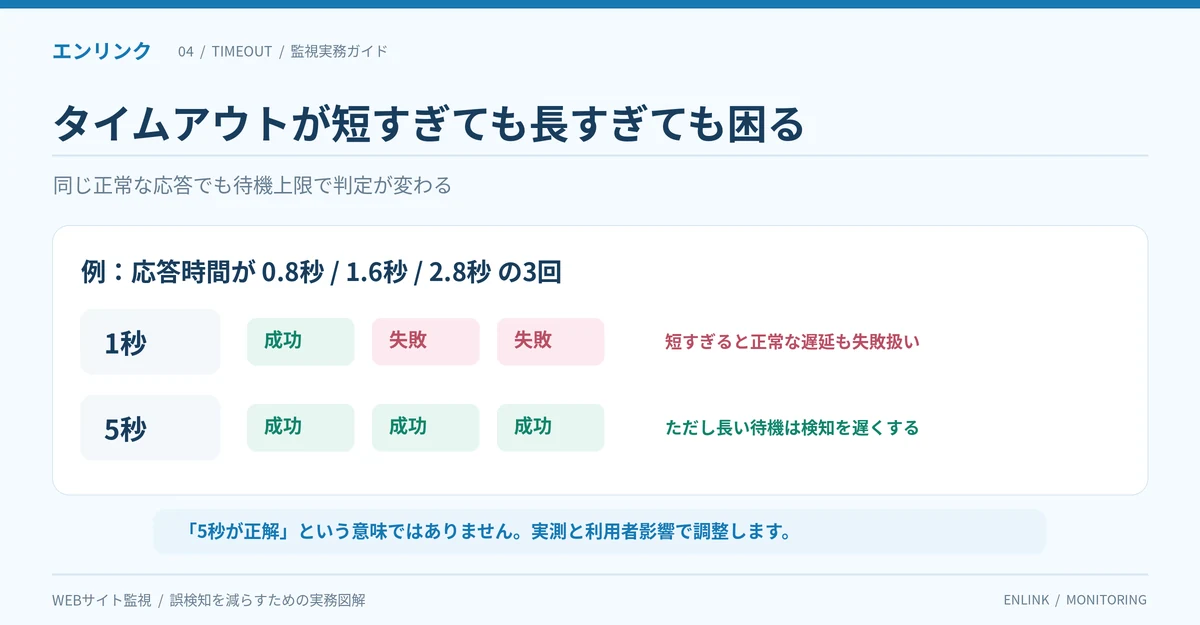
タイムアウトを短くすれば遅い応答を早く検知できますが、正常な通信でも時折その秒数を超えるサイトでは失敗が増えます。長くすれば一時的な遅延に耐えやすい一方、応答しないサイトの判定が遅れます。長いタイムアウト=正確な監視ではありません。
再試行は同じ検査サイクル内での追加確認
再試行は、最初の失敗が続くかを短い時間内に確認する方法です。例えば1回目のリクエストがタイムアウトし、数秒後の再試行は成功した場合、最初の失敗は記録に残しつつ、検査サイクル全体では「障害確定を保留する」というルールが考えられます。
この仕組みを使うには、監視サービス側が再試行に対応している必要があります。製品によっては、個別リクエストの再試行は提供せず、次の定期チェックが成功するかで連続失敗数を判断することもあります。再試行できるかと、連続失敗で判定できるかは別です。
連続失敗は次の検査サイクルまで含めて判断する
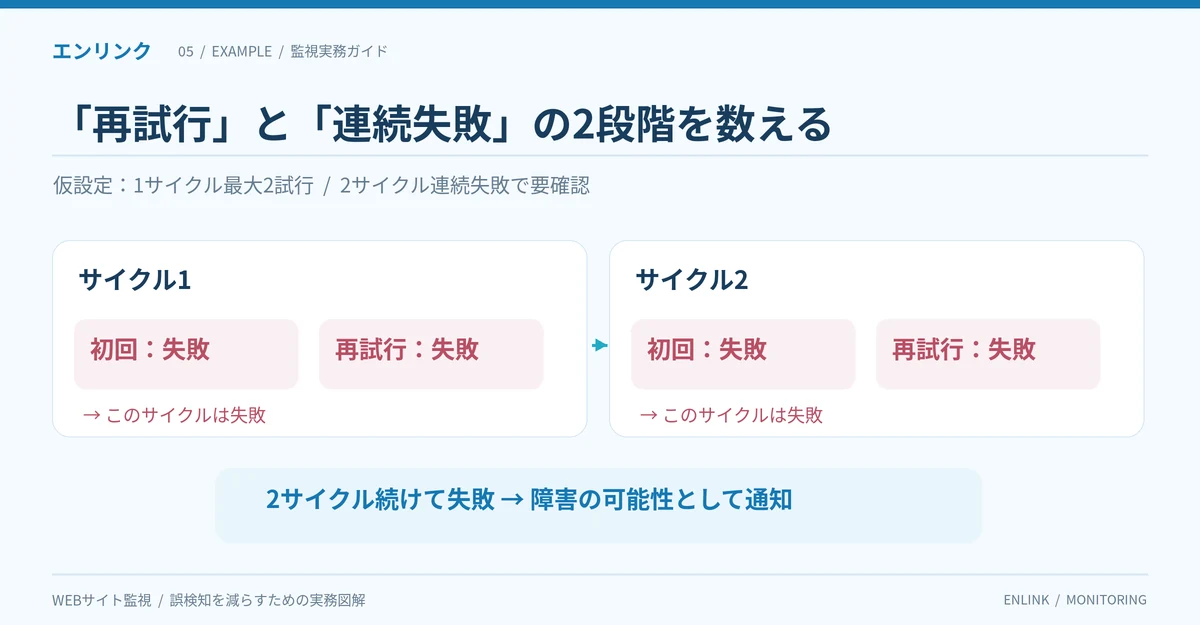
「2回連続で失敗」をどう数えるかは重要です。この記事の説明例では、初回と再試行が両方失敗したら「その検査サイクルは失敗」とし、失敗サイクルが2回続いた場合に障害の可能性を記録します。つまり1サイクル内の試行回数と失敗サイクルの連続数を分けています。
実際のサービスでは「リクエスト単位で2回」「定期チェック単位で2回」「2地点で同時失敗」など意味が違うことがあります。設定名だけで判断せず、何を一回と数えるかを確認してください。Amazon Route 53のヘルスチェックにも連続失敗回数による判定がありますが、各製品の仕組みをそのまま同一視してはいけません。
再試行を増やすほど検知は遅くなり得る
全体タイムアウト5秒、初回失敗時の追加再試行2回、再試行間の待機2秒と仮定します。毎回タイムアウトまで待つケースでは、1サイクルの判定に最大で概ね5秒×3試行+2秒×2回=19秒程度かかります。さらに次回の定期チェックの結果を待つ設定なら、通知はその分後ろへずれます。
この19秒は説明用の単純計算です。実際にはタイムアウトの内訳、並列実行、処理キュー、スケジュール方式によって変わります。重要なのは、秒数と再試行回数を増やした影響を合計で見ることです。
単発失敗を通知する前に確認する判定フロー
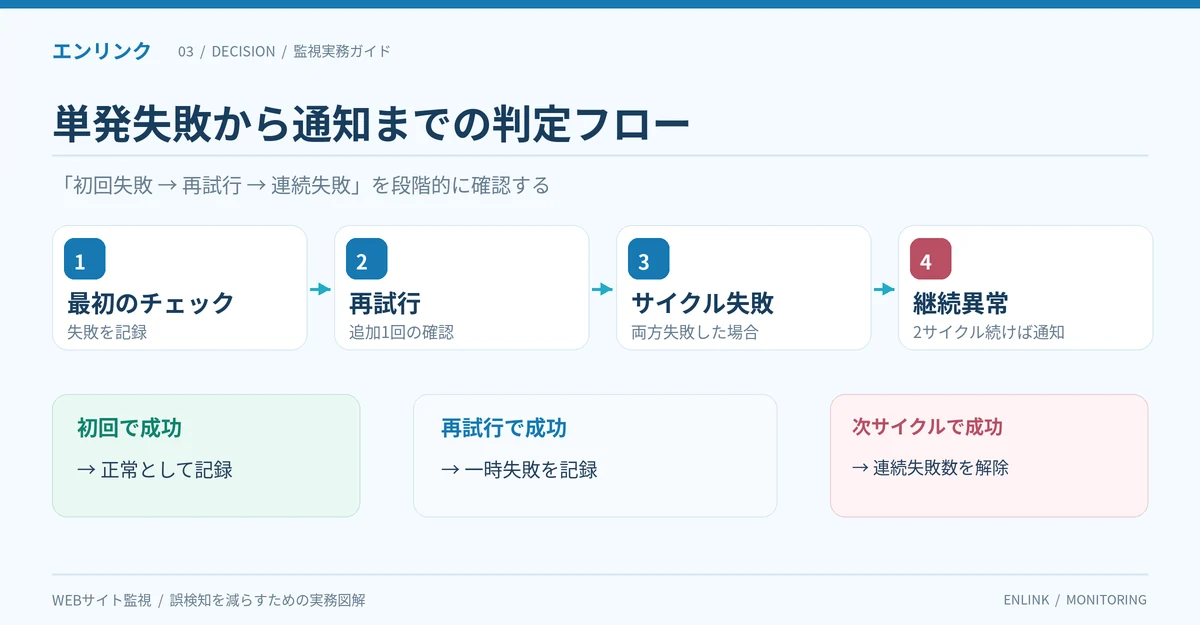
監視から通知へ進む流れを、具体的な分岐として整理します。ここでは一般的なHTTP監視ツールが「初回の失敗後に1回再試行できる」「失敗した検査サイクルを連続で数えられる」と仮定しています。実装方法は各ツールの仕様に合わせてください。
1回目が失敗しても、まずは失敗の事実を記録する
最初のチェックでタイムアウト、接続拒否、想定外のステータスなどが出たら、時刻とエラー種別を保存します。この段階でただちに「全利用者がアクセス不能」と決めるのではなく、指定した監視条件では失敗したという事実を残します。必要なら要確認の状態として扱います。
失敗を記録せずに再試行の成功だけを残してしまうと、同じ時間帯に何度も短い問題が起きていたか分からなくなります。通知の抑制と、観測データの削除は別の話です。誤検知を減らす設計でも初回失敗の情報は保持しましょう。
再試行が成功した場合は障害確定を保留する
例として、最初のチェックがタイムアウトした後、数秒後の再試行が正常に完了したとします。一般的なルールでは「このサイクルは復旧済みまたは一時失敗」として扱い、緊急通知を抑えることが考えられます。ただし、最初の失敗が実際の瞬断だった可能性は残るため、「誤検知だった」と断言してはいけません。
繰り返し同じ現象が起きるなら、警告ではなく傾向として蓄積し、応答時間や失敗地点を調べます。再試行が成功するから放置してよいのではなく、何回も救済される状態が続いていないかを確認することが重要です。
再試行も失敗したら連続失敗数を確認する
初回も再試行も失敗した場合、そのサイクルを失敗として数える例です。失敗サイクルが1回なら要確認、次のサイクルも失敗したら障害の可能性として通知するなど、二段階の判定ができます。途中に成功サイクルが挟まった場合は連続失敗数をリセットする設計が一般的です。
一方、Webサイト全体の障害が疑われる明確なエラーが出ている場合や、重要な業務サービスでは単発でも早く知らせたいことがあります。連続失敗だけに頼らず、重大度やサイトの用途に応じて通知の優先順位を分ける余地を残しましょう。
通知後の再確認と復旧判定も設計しておく
障害の可能性が通知された後、1回成功しただけで直ちに復旧とする場合は「障害→正常→障害」を短時間で繰り返すことがあります。復旧側にも複数の成功や一定時間の安定を条件とする考え方があります。ただし厳しすぎる復旧条件では、実際に直っていても表示が長く異常のままになります。
「障害を検知する条件」「復旧と判断する条件」「同じ事象を再通知する条件」は独立して整理すると混乱を避けられます。通知を減らす目的で復旧表示を不必要に遅らせず、担当者が何を確認すればよいかまで含めて設計してください。
タイムアウトは何秒が適切?短すぎる設定を見直す
タイムアウトの適切な秒数は、サイトが普段どのくらいで応答するか、監視がどの処理を完了条件とするかによって変わります。「3秒が正解」「10秒なら安心」という共通の答えはありません。まず正常な時間帯の応答時間を実測し、利用者影響も考えながら決めます。
普段の応答時間とP95を確認する
正常時の応答時間がほとんど0.5秒程度でも、まれに2秒かかるサイトと、普段から4秒程度かかるサイトでは、同じ3秒タイムアウトでも失敗の起き方が異なります。平均値に加え、P95(遅い側の値を把握する95パーセンタイル)や最大値、ピーク時間帯の推移を確認すると、短すぎる設定に気づきやすくなります。
ただしP95は全測定の95%がその値以下になるという統計的な指標で、監視ツールのタイムアウトを機械的にP95の何倍に決めればよいという公式ではありません。測定した監視地点、時刻、ページの処理内容も確認してください。異常に遅い応答を見逃さないようにする目的も必要です。
接続タイムアウトと処理全体のタイムアウトを分けて理解する
監視ツールには、TCP接続の確立などに対する接続タイムアウトと、HTTPリクエスト全体の完了までに対する全体タイムアウトを別々に設定できるものがあります。接続自体ができないケースと、接続は成功してもページの応答が遅いケースでは、調べる場所が異なります。
例えば「接続2秒、全体8秒」という設定は説明用の一例です。これが適切かは対象の通常応答とツールの仕様によります。接続時間の上限が全体時間に含まれるのか、リダイレクトのたびにリセットされるのかも製品ごとに異なるため、実際の設定画面やドキュメントを確認してください。
タイムアウトを長くしすぎると本当の遅さを隠す
「失敗が多いから30秒へ延ばす」という変更で通知が減ったとしても、サイトが利用者にとって快適になったとは限りません。ページが毎回20秒かかっているのに監視が成功扱いになっているなら、利用者は実際には待たされ続けているかもしれません。
監視では応答の成功・失敗とは別に、応答時間の推移を確認することが重要です。タイムアウト値は「失敗するかどうか」を調整するだけでなく、利用者が許容できる応答の遅さと整合しているかを考えます。遅いサイトを無条件で正常とみなすための変更は避けましょう。
監視側のタイムアウトとHTTP 504は同じではない
監視側が5秒待っても応答を受け取れず処理を中断した場合、HTTPのステータスコードを一切取得できていない可能性があります。一方、504 Gateway Timeoutは、ゲートウェイやプロキシーが上流の応答を所定時間内に受け取れなかった場合などに返すHTTPレスポンスです。
監視が自分の待機上限に達した「タイムアウト」と、サーバーから実際に返されたHTTP 504は区別してください。原因候補を調べるときには、ステータスコードが記録されているか、DNS・接続・TLS・応答待機のどこで失敗したかを確認します。
再試行は何回がよい?回数と待機時間の決め方
再試行は一時的な通信失敗を確認する有効な手段ですが、回数を増やせば必ず正確になるわけではありません。最初に確認したいのは、同じ条件で試しているか、再試行までの時間が短すぎないか、追加のアクセスがサイトに影響しないかです。
追加1回の再試行を仮の出発点にする
一例として「初回チェックが失敗したら、短い待機後に1回だけ追加で確認する」という設定があります。これなら一度だけの一時失敗を確認しつつ、増えるリクエスト数や判定遅延を比較的抑えられます。ただしこの回数を全サイトへの推奨値として固定するものではありません。
再試行を行っても、同じ監視地点の経路が継続して不調なら2回とも失敗する可能性があります。逆に2回目が成功したとしても、最初の失敗が利用者へ影響しなかったと証明できるわけではありません。記録には両方の結果と時刻を残してください。
再試行間の待機時間は短すぎても長すぎても問題
失敗した直後に即座に同じリクエストを連打すると、ネットワークの一時的な混雑が続いている間に同じ失敗を繰り返すかもしれません。逆に間隔を長く取りすぎれば、異常を確かめるまでの時間が伸びます。秒数を決める際はサービスの重要度とアクセス負荷を考慮します。
バックオフやランダムな揺らぎ(ジッター)を利用して、大量の監視対象が同時に再試行しないようにする考え方もあります。ただし小規模なHTTPチェックでは、複雑な制御より、まず再試行回数と最大待機時間を明確にした方が管理しやすい場合があります。
再試行が危険なURLを対象にしない
公開ページのGETによる安全な読み取り確認と、問い合わせ送信・予約確定・購入・削除などの状態変更処理は区別する必要があります。再試行できる仕組みを使って送信処理を繰り返すと、二重登録や重複メール、課金などの問題が生じる恐れがあります。
この記事で想定するのは、許可された公開URLなどへの読み取り確認です。送信や操作の成否は別の安全なテスト方式で検証してください。監視対象URLの具体的な選定基準は、監視するURLの選び方で解説しています。
失敗の種類によって再試行の意味は変わる
タイムアウトや一時的な接続失敗なら、再試行で状況を把握しやすい場合があります。一方、恒常的な404、認証が必要なURLへの401・403、TLS証明書の不一致などは、何度繰り返しても同じ結果になることがあります。再試行の回数を増やす前に、正しいURLや監視条件になっているか確認することが先決です。
また500番台のエラーはサーバー側の問題を示すため、利用者に影響がないと決めつけられません。「再試行で成功したからエラーをなかったことにする」運用ではなく、原因別に傾向を追える記録を残すことが重要です。
連続失敗しきい値と通知条件を設定する具体例
「初回と再試行が両方失敗した検査サイクルを、何回連続で確認したら通知するか」を決める例を示します。以下の数値は一般的な監視設計を説明するための仮設定であり、エンリンクの設定画面で変更できる項目や、特定製品の推奨値を示すものではありません。
| 想定するサイト | 全体タイムアウト | 失敗時の追加再試行 | 通知までの失敗サイクル | 考え方 |
|---|---|---|---|---|
| 企業・情報サイト(例A) | 5秒 | 1回 | 2回連続 | 短い失敗のノイズを抑える |
| 申込受付など重要サイト(例B) | 5秒 | 1回 | 1回で要確認、継続時に重大扱い | 緊急性を優先し段階的に扱う |
| 通常応答が比較的遅いサイト(例C) | 10秒 | 1回 | 2回連続 | 実測を踏まえ、遅延も別途確認 |
例えば例Aは「5秒・1回・2回」という組み合わせです。ただしタイムアウト5秒が適切かどうかは正常時の応答時間によります。こうした値は試験の出発点と考え、監視履歴、サイトの応答特性、業務への影響を確認して変更する必要があります。
例A:一度失敗しても再試行が成功した場合
10時00分に最初のチェックが失敗し、短い待機後の追加チェックで成功したとします。このとき「初回失敗は記録」「検査サイクルは未確定の障害として扱わない」というルールが考えられます。緊急通知は抑制できても、初回失敗のログまで消す必要はありません。
その後も似た失敗が頻発するなら、監視地点や応答速度の確認が必要です。単発の一時障害を集めて分析できるようにしておけば、「通知のノイズを減らすこと」と「問題の兆候を見逃さないこと」を両立しやすくなります。
例B:2サイクル連続失敗した場合
10時00分の検査サイクルで初回と再試行がともに失敗し、次の検査サイクルも同じように失敗したとします。「2サイクル連続失敗」を障害の可能性と判定する設定なら、この段階で通知対象となります。次回チェックまでの間隔が長いほど、この判定は遅くなります。
重要な決済・予約などのサイトで、1サイクル目の失敗も見逃したくない場合は、その時点で「要確認」の記録を確認するなど、緊急度による運用の違いを設けます。監視頻度そのものの選び方は基礎記事に譲り、ここではいつ異常と判断して対応を始めるかというルールを重点的に考えます。
「2回連続」と「2回再試行」は同じではない
初回を含めて合計3回アクセスすることを「再試行2回」と呼ぶ一方、独立した2回の定期検査が失敗することを「2回連続失敗」と呼ぶ場合があります。両方の仕組みを利用するなら「初回+再試行で1サイクル」「失敗サイクルを何回確認するか」を設定書に明示します。
例えば「1サイクルで最大2試行」「2サイクル連続失敗」の場合、両方のサイクルがタイムアウトで失敗すれば最大4回の試行が行われる例になります。この4回は単純な説明上の回数であり、間隔、再試行方法、実行地点の違いにより、実サービスの動作が完全に一致するとは限りません。
偽陰性にも注意して調整する
誤検知(実際にはユーザーに影響がなかったのに異常と判定すること)を減らそうとして、継続失敗の条件を厳しくしすぎると、実際には発生した短時間の停止を通知せず終わることがあります。これは見逃し、つまり偽陰性の問題です。
どちらを重視するかは事業によって異なります。情報サイトの一時的な取得失敗と、会員登録が止まった状態とでは許容範囲が違います。過去の障害履歴やテスト結果と照合し、通知の必要性と見逃しのリスクの両方を評価して調整してください。
監視地点やWAFなど、設定以外の原因も切り分ける
再試行とタイムアウトの値を調整しても失敗が減らない場合は、設定値だけが問題ではない可能性があります。通信経路、監視URL、セキュリティ制限、サーバー内部の状態を確かめると、原因を絞り込みやすくなります。
一つの監視地点だけ失敗していないか確かめる
ある監視地点では接続できず、別の地点では正常なことがあります。地域ごとのネットワーク障害やDNSの差、監視拠点側の問題が原因かもしれません。Google Cloud Monitoringの公式資料でも、一地点だけが失敗する場合と、複数地点で失敗する場合を区別したアラート設計が説明されています。
ただし「ほかの地域は正常だから問題なし」とするのも不適切です。その地域の実際の利用者がアクセスできていない可能性があるためです。複数拠点での一致を求める場合も、利用者の地域分布と影響度を考慮してください。監視ツールが複数地点に対応するかも事前確認が必要です。
WAFやBot対策が監視アクセスを拒否していないか確認する
セキュリティ機能が監視サービスからのアクセスだけをBot扱いし、403や接続制限を返すことがあります。この状態を単純な「サイトがダウンした」と判断すると誤検知になります。一方、利用者へのアクセス制限が実際に起きているなら、本当の障害の可能性もあります。
WAFの検知ログ、監視のアクセス元、対象URL、User-Agentなどの条件を管理者が確認してください。警告を減らすために保護機能を全面解除するのは避けます。正当な監視だけを許可する設定が必要な場合も、影響を理解したうえで最小限の範囲に限定します。
監視URLやリダイレクトが変更されていないか調べる
リニューアルで旧URLが404になった、HTTPからHTTPSへ移動した、公開ページがログイン必須に変わったといった場合、以前の設定が正常なサイトを失敗と判断することがあります。まず監視対象URLと最終到達URL、期待するステータスを確認しましょう。
また、転送が何段も続けばチェックの応答時間が長くなる場合があります。サイト全体のURL選定方法を詳しく知りたい場合は、監視URLの選び方も参照してください。
監視基盤の欠測を正常・異常と混同しない
監視を実行する基盤自身が停止した場合や、データの取得が行われていない場合は、サイトの正常・異常を判断できません。こうした「未計測」を、単純に成功や失敗へ置き換えると実態と違う数字になります。
監視の実行有無、エラーの種類、欠測期間を記録し、サイトにアクセスできなかったのか、監視処理が行われなかったのかを区別しましょう。通知の抑制とは別に、監視基盤自体の安定性を点検することも必要です。
誤検知の改善効果を確かめる実務手順
設定を変更したら、単に「通知が減ったから成功」と判断せず、実際の障害を検知できたかを確かめます。過去のログと、変更後の観測記録を比較し、何を改善し、何が見えなくなったかを整理しましょう。
手順1:誤検知と思われた事例を分類する
まず直近のチェック失敗を、タイムアウト、接続拒否、DNS解決、TLS、HTTPの4xx・5xx、監視処理の欠測などに分類します。さらに「次回は成功した」「別地点では正常だった」「利用者からも不具合報告があった」などの事実を付け加えます。
この時点では根拠が不十分なものを全て誤検知と呼ばず、「未確認」「一時的な不具合の可能性」などの扱いを残します。エラーの原因を分類すれば、タイムアウトを調整すべきなのか、URLを修正すべきなのか、サーバーの問題を調査すべきなのかを分けられます。
手順2:正常時の応答時間と失敗時刻を重ねる
監視ログから、正常時の応答時間、タイムアウトした時刻、失敗が集中した時間帯を確認します。例えば毎日ほぼ同じ時間に遅くなるなら、定期処理やバックアップなどサーバー負荷の増加が関係している可能性があります。
普段の応答時間が設定した待機上限に近い場合は、タイムアウトの値が短すぎる可能性があります。しかし本当に遅くなっているなら、監視設定を緩めるだけでなくサイトの処理を改善する方が重要です。監視値の変更と、サイト性能の改善は別の対応として記録してください。
手順3:再試行・連続失敗のルールを試験する
過去のチェック列を使い「単発失敗→成功」「失敗→失敗」「失敗→成功→失敗」などの並びで、設定ルールがどう判定するか確かめます。実際の監視機能がサイクル内の再試行に対応するなら、そのログも含めます。通知の有無だけでなく、失敗履歴が保持されるか、復旧判定が適切かもチェックします。
本番サイトを意図的に停止させる必要はありません。監視ルールを検証できるテスト環境や過去データがあれば、それらを使う方が安全です。検証で分からなかったことは未確認として残し、値を一度に大きく変えず、影響を見ながら調整します。
手順4:変更前後の見逃し・通知負担を比較する
一定の期間を置き、担当者が確認した通知件数、継続異常として判定された件数、実際の利用者影響の有無、検知から復旧までの流れを振り返ります。通知が減っても、利用者が困った障害を見逃しているなら良い改善とはいえません。
結果を比較するときは、季節やサイトの更新頻度、アクセス負荷が変わっていることも考慮します。完璧な統計がなくても、何を理由に秒数・回数を変更したかを記録すれば、誤検知が増えたときに元へ戻しやすくなります。
エンリンクの連続失敗判定と確認できる機能
エンリンクの公開機能一覧には、HTTP/HTTPSの定期監視、チェックごとのHTTPコードや応答時間、連続失敗による障害判定、監視履歴、管理画面内のアラートが案内されています。この記事の一般的な再試行・タイムアウトの設定例と、実際にサービスで公開されている機能を混同しないようにしてください。
公開機能一覧では連続失敗による障害判定を案内
エンリンクの機能一覧では、チェックが一定回数続けて失敗した場合に障害の可能性として記録し、失敗回数や判定理由を確認できる旨が掲載されています。一度の通信失敗と継続的な異常を区別して見られることが、公開されている機能の一つです。
しかし、同一検査サイクル内での即時再試行や、利用者自身による再試行回数・タイムアウト秒数・連続失敗しきい値の自由設定ができるかは、現行の公開機能一覧からは確認できません。この記事の設定表を「エンリンクの管理画面にそのまま入力できる」と受け取らないようにしてください。最新の対応範囲は機能一覧で確認できます。
監視履歴で結果と判定理由を照合する
公式ページでは、チェック日時、結果、HTTPコード、応答時間、判定理由などを時系列で確認できると案内されています。例えば一度だけ失敗した時刻と、次のチェックで正常に戻ったかを並べて確認すると、継続した問題かどうかを考える材料になります。
ただし監視の記録だけから、利用者全員に影響する停止があったかどうかや、秒単位の実停止時間を確定できるわけではありません。サーバー管理者のログや公式障害情報、利用者からの報告などと突き合わせて判断します。
料金プランと監視頻度は別ページで確認する
2026年10月23日現在、エンリンクの無料プランは最大5サイトまで登録でき、定期監視は1日2回と案内されています。有料プランでは契約プランに応じて最短15分・5分・1分の監視間隔を選べますが、実行時刻や障害検知までの時間は保証されません。最新の条件は料金プランで確認してください。
監視間隔そのものの考え方と、この記事で扱う再試行・連続失敗の判定条件は別です。まず公開サイトの応答結果を確認したい場合は、エンリンクの無料アカウント登録から利用を始められます。機能範囲を理解し、必要な追加検査は別の手段で補うようにしましょう。
死活監視の誤検知でよくある質問
再試行・タイムアウト・失敗回数の設定で迷いやすい質問をまとめます。各値はサイトや製品によって適切なものが異なるため、数字だけを一律に当てはめず、意味と影響を確認してください。
死活監視の誤検知を最も簡単に減らすには?
1回の失敗で即座に障害確定とするのではなく、再試行や連続失敗などの確認条件を設けることが選択肢になります。どの機能が使えるかは監視サービス次第です。また、監視対象URLが正しいか、WAFが監視アクセスを拒否していないかの確認も必要です。
再試行は何回に設定するのが正解ですか?
すべてのサイトに通用する正解はありません。失敗時に追加1回再試行する例は考えられますが、通常の応答時間、監視コスト、障害の緊急性を確認して調整する必要があります。再試行を増やしすぎるとチェック負荷と判定遅延が増えます。
タイムアウトは3秒と10秒のどちらがよいですか?
普段の応答時間によります。通常時に5秒かかるサイトへ3秒を設定すると失敗が増えやすく、通常は0.5秒で応答するサイトへ10秒を設定すると異常な遅さを見逃す可能性があります。P95や遅い時間帯を確認し、利用者が困る応答時間も踏まえて決めてください。
2回連続失敗したら必ず本当の障害ですか?
いいえ。同じ監視地点のネットワークが継続して不調だったり、WAFがその地点だけを拒否したりすれば、2回連続で失敗する場合もあります。連続失敗は異常の可能性を高める材料ですが、障害の原因や利用者への影響まで確定するものではありません。
1回失敗して次が成功したら通知しなくてよいですか?
事業上の影響によります。緊急通知を抑え、監視履歴に残す運用は考えられますが、短時間でも実際に止まっていた可能性があります。重要な決済・受付サイトでは、単発の失敗も要確認として扱う方法があります。
復旧通知が何度も繰り返されるのを防ぐには?
障害判定だけでなく復旧判定にも連続成功などの条件を使う考え方があります。また同じ異常が継続している間は、同一事象としてまとめて記録することも役立ちます。ただし製品によって対応方法が異なり、条件が厳しすぎると復旧したのに表示が遅れるため注意してください。
エンリンクでタイムアウト秒数を自由に変更できますか?
現在の公開機能一覧では連続失敗による障害判定や監視履歴が案内されていますが、利用者向けのタイムアウト秒数変更や即時再試行回数の設定画面があることは確認できません。この記事の数値は一般的な監視設計の説明例です。エンリンク固有の対応範囲は公式の機能一覧をご確認ください。
まとめ:単発失敗は記録し、継続異常は確認して通知する
死活監視の誤検知を減らすには、チェックに失敗したという事実と、対応が必要な障害の可能性を分けることが大切です。タイムアウトで1回の試行の待機上限を決め、対応するツールなら再試行で一時的な失敗を確認し、必要に応じて連続失敗条件で通知の判断を行います。
ただし通知条件を厳しくするほど、本当の短時間障害を見逃したり、重大な問題への対応が遅れたりする可能性があります。初回失敗のログは残し、正常時の応答時間、監視地点、WAF、URLの変更、利用者からの報告を照合して調整してください。通知を減らすことではなく、実際に役立つ異常判定を作ることが目的です。
エンリンクではHTTP/HTTPSの定期監視、連続失敗による障害の可能性の記録、監視履歴などが案内されています。まず管理中のサイトの結果を確認したい方は、5サイトまで無料で使えるエンリンクから始められます。提供中の機能を確認し、必要に応じて別の監視手段も組み合わせましょう。
参照した公式資料:Amazon Route 53「ヘルスチェックの設定値」、Amazon Route 53「ヘルスチェックの動作」、Google Cloud「Create public uptime checks」、Google Cloud「Troubleshoot uptime checks」、Prometheus「Alerting rules」、Google SRE「Monitoring Distributed Systems」、MDN「504 Gateway Timeout」(参照日:2026年10月23日)。