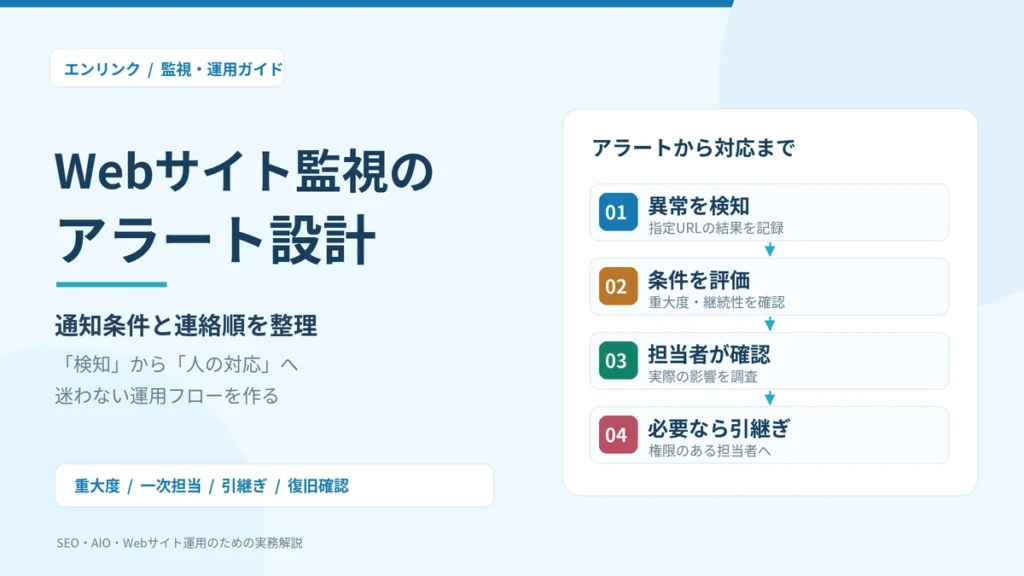
Webサイト監視のアラートは、単に「サイトが落ちたら通知する」と決めるだけでは十分ではありません。どの異常を緊急扱いするか、誰が最初に確認するか、対応できなければ誰へ引き継ぐかまで決めて初めて、障害への対応につながります。通知がたくさん届いても、誰も確認しなければサイトは復旧しません。
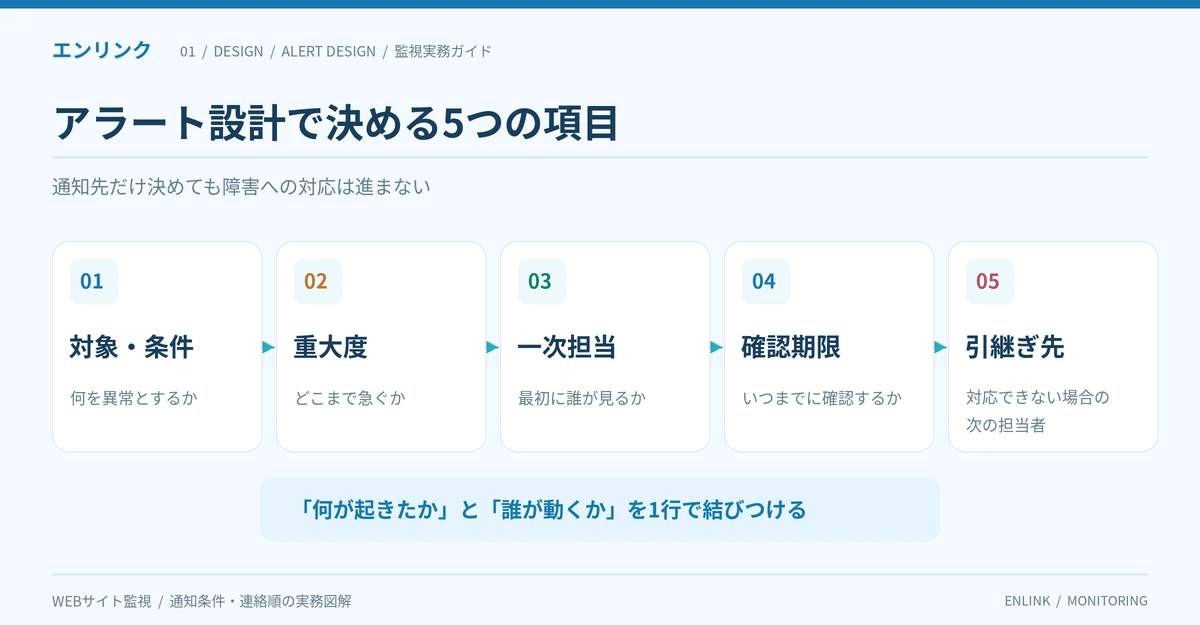
おすすめの整理方法は、①監視対象と判定条件、②重大度、③通知先、④確認までの目標時間、⑤エスカレーション先の5項目をセットにした「アラート運用表」を作ることです。例えば、申込ページの継続的な接続失敗は優先度を高くし、まず運用担当者が確認します。担当者が対応できなければあらかじめ決めた次の担当者へ引き継ぎ、復旧後は外部から再確認して記録します。
この記事では、企業サイト・ECサイト・採用サイト・複数サイトを保守する制作会社向けに、通知条件、担当者ごとの役割分担、連絡順、具体的な運用表、エスカレーションのフロー図を説明します。死活監視の仕組みと監視頻度の基本、誤検知を減らすための再試行・タイムアウト設定とは検索意図を分け、ここでは異常を見つけた後に人が動くための設計を中心にします。
Webサイト監視のアラート設計で決める5つの項目
最初に必要なのは通知先のアドレス入力ではなく、対応すべき異常を誰がどう処理するかの全体設計です。5つの項目を分けておくと、監視ツールを乗り換えた場合にも運用ルールを再利用しやすくなります。
1.どのURLと機能を監視するか
トップページ、問い合わせ入口、求人・応募ページ、予約・ログインなど、サイトの利用目的に応じて対象を選びます。公開URLのHTTP応答だけを確認する監視では、問い合わせの送信成功や決済完了は検証できません。監視結果が意味する範囲を先に定義してください。
事業上重要なURLを選ぶ方法は、監視URLの選び方と優先順位にまとめています。アラート設計では、選んだURLごとに「このURLが利用できないと誰が困るか」を一行で書き添えることが重要です。
2.何が起きたら異常と判定するか
接続失敗、タイムアウト、想定外のHTTPステータス、応答時間の悪化、証明書期限の接近など、判定条件を具体的に記録します。「異常があったら通知」と書くだけでは、どの状況で通知されるかが不明です。監視対象URL、取得したコード、失敗の回数、判定時刻をセットで扱います。
1回の失敗をそのまま障害確定とするのか、再確認・連続失敗を条件とするのかによって、通知の速さと誤検知の発生しやすさが変わります。数値は対象サイトの通常時の状態から判断し、すべてのサイトに同じしきい値を強制しないようにします。
3.異常の重大度をどう区分するか
ECの購入入口が長時間停止している状態と、数秒だけ応答が遅くなった状態では、必要な対応が異なります。アラートを「緊急」「要対応」「参考」などに分けておけば、担当者は重要なものから確認できます。
重大度は監視ツールが自動で決めるとは限りません。影響する機能、利用者の範囲、停止の継続時間、代替手段の有無を運営側で整理しておく必要があります。特に利用者からの障害報告がある場合は、機械的な監視結果よりも優先度が高くなる場合があります。
4.最初に誰が確認するか
「運営部門へ連絡」だけでは、実際に誰が見るのか曖昧です。一次確認の担当者または当番、連絡方法、担当範囲を決めます。制作会社に委託している場合は、サイト所有者と保守担当者のどちらが最初に状況確認を行うのかも明確にしましょう。
通知を送る先と、復旧操作をしてよい担当者は一致しない場合があります。担当者は公開画面の確認だけを行い、VPS・データベース・DNSの変更は権限のある管理者が担当する、といった分離も必要です。
5.対応できないときの次の連絡先と復旧判断
最初の担当者が不在、原因を特定できない、復旧作業の権限がない、といった事態を想定して二次担当者を決めます。何分以内に引き継ぐかは運営体制やサイトの重要性に応じた社内の目標として定め、監視サービスの保証時間と混同しないようにします。
最後に「復旧したと判断する条件」も決めます。サーバーの負荷が下がっただけでは、利用者がアクセスできるとは限りません。対象URLの外部応答と、影響した主要な機能を確認してから、事象を閉じることが大切です。
緊急・要対応・参考の3段階で通知を分ける
すべての異常を同じ優先度で届けると、軽い変化が重大な障害を埋もれさせます。まずは3段階程度の運用区分を決め、サイトの用途と影響に合わせて割り当てます。以下は一般的な運用例であり、どの監視サービスにも標準搭載されている設定という意味ではありません。
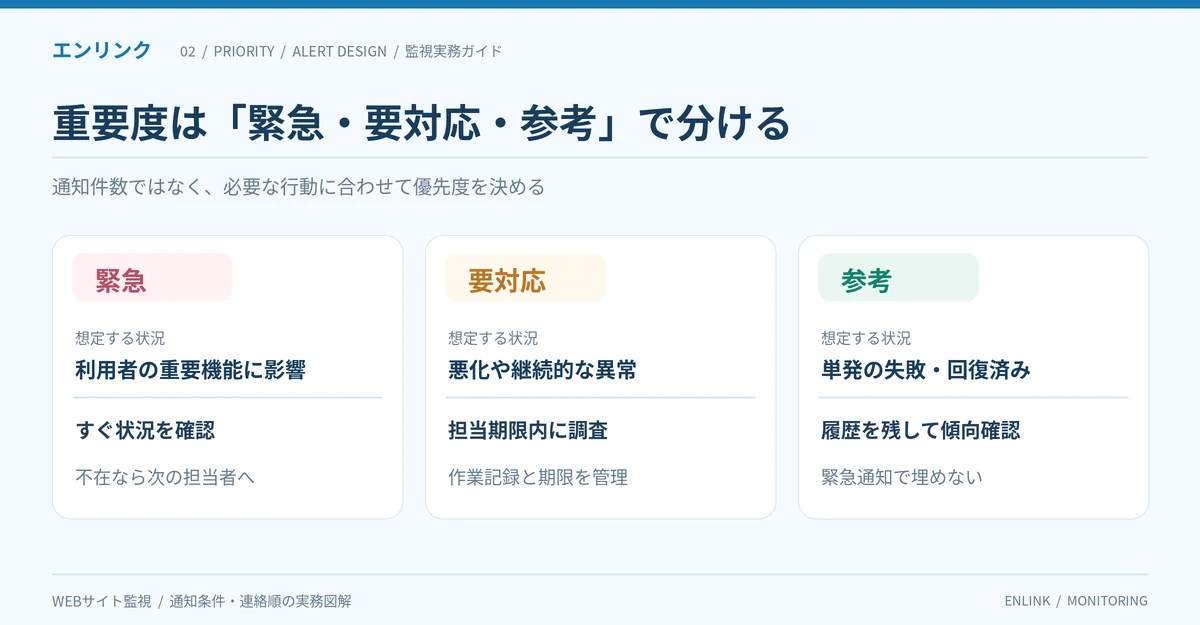
| 重大度 | 異常の例 | 求める行動 | 運用上の扱い |
|---|---|---|---|
| 緊急 | 申込・予約に直結する公開URLの継続失敗、利用者からの広範囲な不具合申告 | 状況確認と影響範囲の判断を優先 | 担当者不在の場合の代替連絡先を事前に決める |
| 要対応 | 重要性が中程度のページの継続失敗、応答時間の悪化傾向 | 担当時間内に調査し、必要なら作業を依頼 | 履歴と対応期限を管理する |
| 参考 | 単発失敗、回復済みの一時異常、状況確認に役立つ変化 | 記録を残して傾向を確認 | 緊急通知を増やさず集約して確認 |
緊急アラートは人の行動が必要な状態に絞る
GoogleのSRE資料では、ページャーなどの緊急通知を、人がすぐに行動すべき問題に使うことが強調されています。「一瞬だけ遅かった」という事実と「現在サイトが利用できず、復旧作業が必要」という状態は分けて考えます。
一方、障害が短くても購入・応募・契約締結などに影響した可能性があるなら、単発の記録を軽視してはいけません。監視の失敗が本当に事業へ影響したかは、利用者の報告やアプリケーションのログなどを照合して判断します。
要対応は期限と担当者を必ずセットにする
緊急ではないアラートを「後で確認する」だけにすると、誰も着手せず放置されることがあります。要対応の事象にも担当者を割り当て、いつまでに調査するかを運用上の期限として決めてください。
例えば「翌営業日の午前中までに状態を確認する」という扱いが考えられますが、これは運営体制に応じた仮のルールです。重要な利用者機能の停止に、その期限が適切だと保証するものではありません。影響が広がった場合に緊急へ切り替える条件も設けましょう。
参考情報は消さずに記録へ残す
単発の失敗を緊急通知しない場合でも、監視履歴に残すことには意味があります。同じ時間帯に短い失敗が繰り返されているなら、後から原因の手掛かりになるためです。通知を抑えることと、観測結果を削除することは同じではありません。
「今日の単発失敗が何件あったか」「特定のドメインだけ集中したか」といった振り返りに活用し、必要なら監視条件やサーバー構成の点検につなげます。収集データの保持期間や集計機能はサービスによって異なるため、実際に使える範囲を確認してください。
通知条件を決めるときは検知と通知を分ける
監視チェックが失敗したこと、アラート条件を満たしたこと、通知処理が実行されたこと、担当者が確認したことは異なる段階です。これらを一つにまとめると「通知済みなのに誰も対応しなかった」ときの原因が分からなくなります。
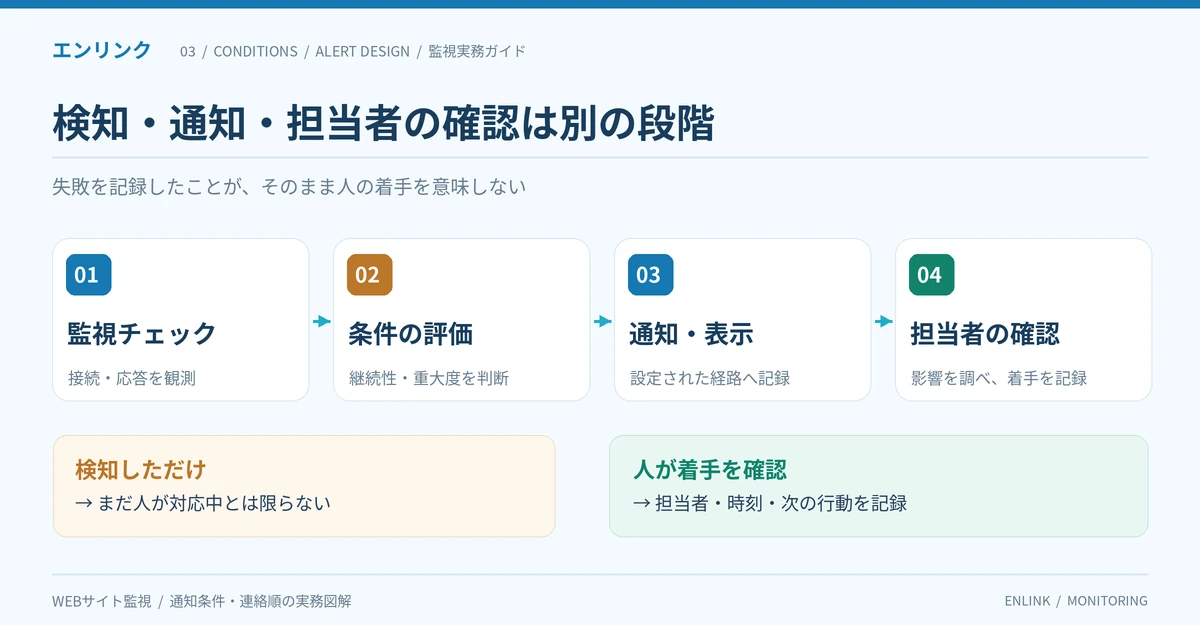
監視の失敗とアラート発火は同じではない
例えば1回のHTTP接続失敗を記録し、次の確認も失敗した場合に初めて「継続異常」とするルールがあります。この場合、最初の失敗記録とアラート発火の時刻は一致しません。再試行や連続失敗判定は通知のノイズを減らす手段ですが、本当の短時間障害を見逃す可能性もあります。
実際の条件は、サービス側が何を「1回」と数えるかによって変わります。再試行1回と連続失敗2サイクルは別の概念です。詳しい判定方法は死活監視の誤検知を減らす方法で解説しています。通知設計では結果を受け取った後の行動を重点的に扱います。
失敗・復旧・未計測を別々の状態にする
通知を設計する際は、失敗したことだけでなく、復旧が確認できたこと、監視が実行されなかったことも区別します。監視システム自体の障害でチェック結果が取得できなかった場合、その時間をサイト正常と決めつけることはできません。
Amazon CloudWatchの公式資料でも、条件違反のデータと欠測データを分け、欠測をどう扱うか設定できることが説明されています。「データが届かないので正常」という処理が適切かは対象の性質で異なります。監視結果の解釈とアラート条件を揃えましょう。
復旧通知は何が回復したかを明確にする
サイトの外部応答が復旧しても、問い合わせ送信や決済が依然として利用できない場合があります。復旧を知らせる条件を「監視対象URLのHTTP応答が成功した」としたなら、通知でもその範囲に限定して表現する必要があります。
また、正常と異常を短い時間で繰り返すと、障害・復旧の通知が大量に発生します。復旧時にも連続成功などの確認条件を設ける方法がありますが、サービスごとの対応状況を確認し、復旧の認定が過度に遅れないようにしてください。
応答遅延やSSL期限の注意を同じ「サイト停止」にしない
HTTP応答の失敗、通常より長い応答時間、SSL証明書の有効期限接近は、それぞれ意味が違います。応答遅延は利用者体験に影響する可能性を示し、SSLの期限接近は将来の接続障害を防ぐための準備事項です。両方を「サイトがダウン」と通知してはいけません。
異常の種類ごとに件名や重大度を変え、必要な担当者へ届く仕組みを考えます。SSLの更新作業の担当者と、アプリケーション障害の担当者が違う場合は、連絡先を分けるだけでも対応しやすくなります。
担当者への連絡順はエスカレーション表で整理する
アラートを「見た」ことと、復旧を「担当する」ことは違います。担当者が不在の場合や、原因調査に権限が必要な場合を想定して、一次・二次・最終判断の役割を決めます。役職だけでなく、実際に連絡を受けられる人と代替担当者を指定することが重要です。
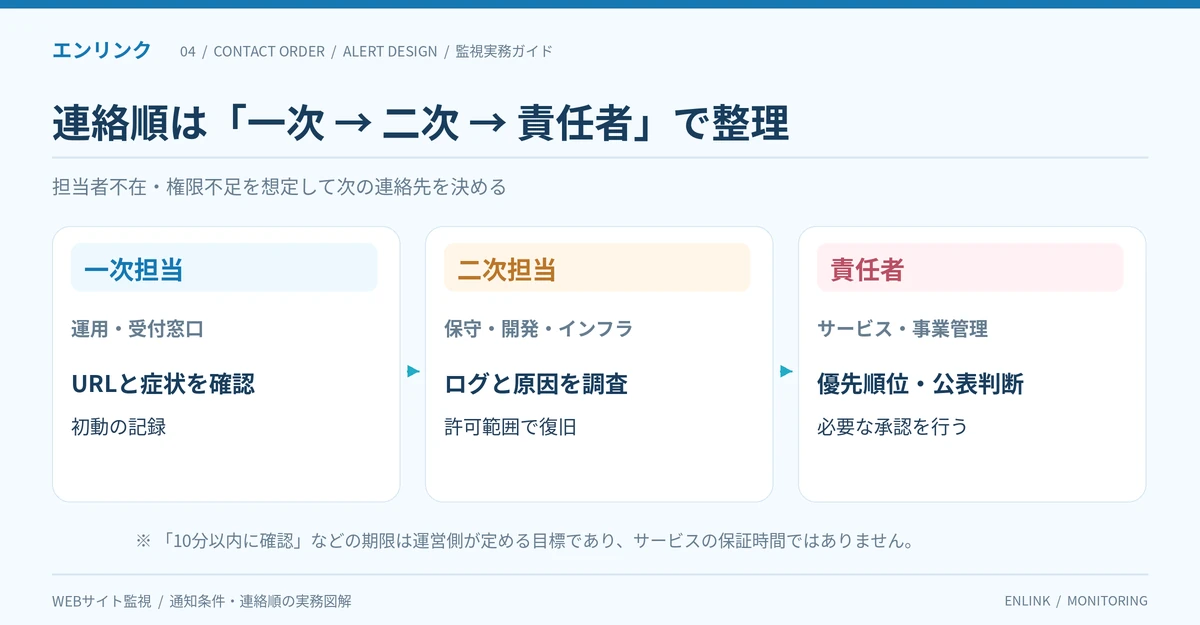
一次担当者は異常の事実と利用者影響を確認する
一次担当者の仕事は、アラートの対象URLと時刻、監視結果、利用者からの問い合わせ有無を確認し、障害の可能性と影響範囲を整理することです。担当者にサーバーの管理権限がなくても、公開画面で再現するか、別回線で確認するかなどの初動は行えます。
最初から根本原因を確定する必要はありません。必要な情報を揃えて次の担当者へ渡すことが重要です。勝手にDNSやサーバー設定を変更したり、権限のないシステムを操作したりしないよう、役割の境界も決めましょう。
二次担当者は原因の切り分けと復旧作業を担う
一次担当者では対処できない場合、インフラ担当者、開発担当者、保守委託先などへ引き継ぎます。二次担当者は、Webサーバーやアプリケーションのログ、DNS・CDN、データベース、直近の変更履歴などを確認し、必要な権限と承認の範囲で復旧を進めます。
引継ぎには対象URL、発生時刻、再現条件、HTTPコードやエラー内容、利用者影響、実施済みの確認を含めます。同じ手順を複数人が繰り返す無駄を避けられ、調査の出発点も明確になります。
事業判断が必要なときは責任者を分ける
長引く障害でサービス停止の告知や受付期間の延長が必要になった場合、技術担当者だけで判断できないことがあります。公表内容や事業上の対応を決める責任者を別に定めておくと、原因調査と対外対応を並行できます。
障害のお知らせを出す、顧客へ連絡する、契約上の対応を判断するといった対外行為は、管理権限や社内ルールに沿って承認された担当者が行います。監視ツールで異常を記録しただけで、外部への謝罪や報告を自動送信する必要があるわけではありません。
確認できない場合の引継ぎ期限を決める
例えば緊急アラートについて「一次担当が10分以内に確認できない場合は二次担当へ」「二次担当でも着手できなければ責任者へ」とする社内ルールが考えられます。しかしこの10分はあくまで組織が自分で設定する例示の期限であり、監視サービスが10分以内の検知・配送・復旧を保証するという意味ではありません。
勤務時間、休日、時差、委託契約、担当者の人数に合わせて無理のない期限にします。担当者不在の夜間に誰も対応できないなら、その体制を変えるか、対応できる時間帯と利用者への影響を明示する必要があります。
通知から復旧までのエスカレーションフロー
連絡順は「監視システムが条件を検出する」「担当者が状況を確認する」「必要なら別の担当者へ引き継ぐ」「復旧後に外部から確認して記録する」という流れで設計します。ここでは一般的な運用フローを示し、利用するツールが自動エスカレーションに対応するかは別途確認する前提です。
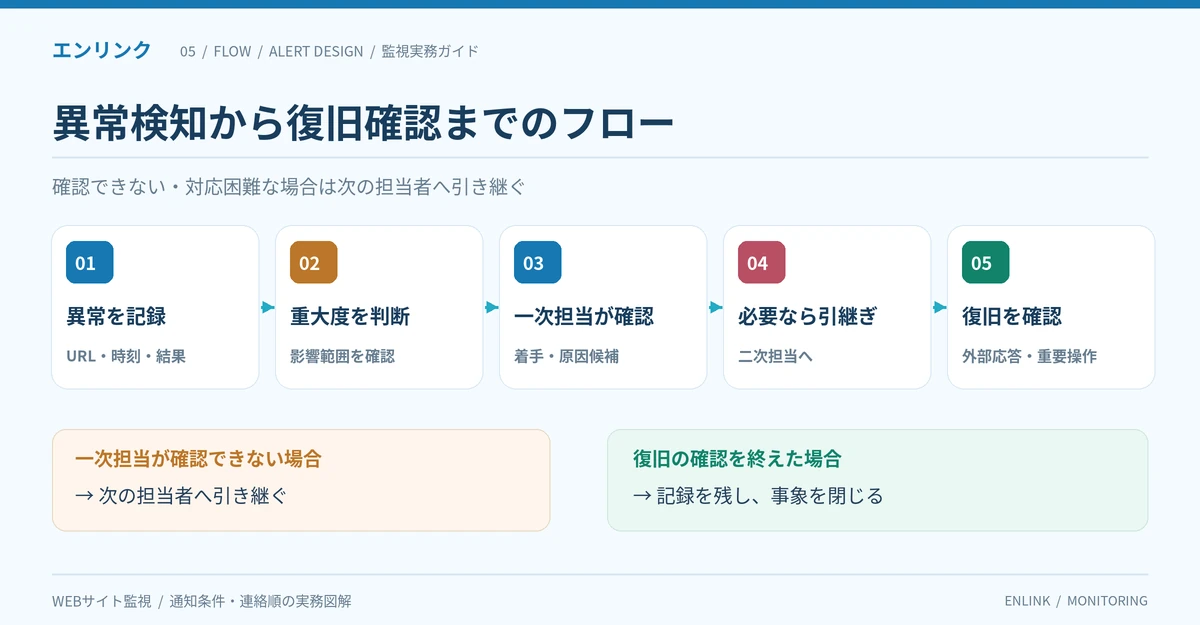
ステップ1:異常の記録と優先度を判断する
指定URLの継続失敗などが検知されたら、サイト名、対象URL、監視時刻、結果、判定理由を記録します。あわせて重要ページへの影響が疑われるか、単発失敗なのか、計画メンテナンス中なのかを確認します。
重要度の判定はあらかじめ作ったアラート運用表に沿って行います。監視地点から1回アクセスできなかっただけでは全利用者の障害と断定せず、「確認すべき異常」として扱います。利用者から具体的な不具合申告がある場合は、その情報も考慮して重大度を調整します。
ステップ2:一次担当が事象を確認し、着手を記録する
通知を受けた担当者は「確認した時刻」「現象が再現するか」「次に行う確認」を記録します。アラートの既読ボタンを押すことと、実際に対応を引き受けたことは必ずしも同じではありません。必要なら別の作業記録や担当管理表で着手状態を分けます。
確認結果が正常に見えても、短い障害が復旧した可能性があります。最初の失敗記録を消さず、サーバー側のログやほかの利用者からの報告と照合します。アラートが継続している場合は、一次担当が復旧できる範囲を見極めます。
ステップ3:未確認・対応困難なら二次担当へ引き継ぐ
社内で定めた時間内に一次担当が確認できない場合や、調査に特別な権限が必要な場合は二次担当へ引き継ぎます。転送する情報は、症状の推測よりも時刻・URL・エラー・再現手順などの事実を中心にします。
例えば「15:20に指定URLで503を確認、別回線でも再現、申込入口に影響あり、サーバーログの確認権限なし」と伝えれば、二次担当が調査を始めやすくなります。担当者交代の際には、誰が現在の対応責任者かも明記しておきます。
ステップ4:復旧と利用者側の確認で事象を閉じる
二次担当が設定修正や切り戻しなどを行った場合でも、作業が完了しただけでは復旧とは言えません。監視対象URLが外部から正常に応答するか、必要なら問い合わせ・申込など主要な操作が利用できるかを確認します。
復旧確認の時刻、確認した内容、未解決の影響、再発防止に向けた担当者を記録します。復旧通知を出す場合は、確かめた範囲を超えて「全機能の正常を保証」といった表現をしないようにします。
サイト別に考えるアラート条件と連絡先の設定例
アラート運用表はサイトの用途によって変わります。ここでは具体例として、企業サイト、EC・予約サービス、複数サイトを管理する制作会社を取り上げます。時間や担当者の呼び方は説明用であり、実際に採用するときは自社の営業時間・責任範囲・契約条件に合わせてください。
| 対象 | 条件の例 | 一次担当 | 二次担当 | 記録・判断すること |
|---|---|---|---|---|
| 企業サイト | 問い合わせ入口の継続的な取得失敗 | Web運用担当 | 制作・サーバー保守担当 | 受付入口への到達可否と利用者影響 |
| EC・予約 | 購入・予約入口で外部応答が継続失敗 | 運用当番 | 開発・インフラ担当 | 購入・予約の操作可否を別途確認 |
| 採用サイト | 募集一覧・応募案内ページの継続失敗 | 採用Web担当 | 応募システム担当 | 受付期間中か、実際の応募処理に影響するか |
| 制作会社の管理先 | 顧客サイトの公開URLの継続失敗 | 保守窓口 | 各サイトの契約・管理担当 | 委託範囲、対応権限、顧客への報告要否 |
企業サイトは問い合わせ入口への影響を優先する
企業サイトでは、トップページが開いていても問い合わせフォームの入力画面に到達できない場合があります。受付入口が重要な導線なら、そのURLの外部応答が継続失敗したときの扱いを事前に決めます。ただしフォーム表示だけを監視しても、送信処理やメール配送の正常は確認できません。
一次担当は表示できるかを確認し、原因が不明なら制作・サーバー保守担当へ引き継ぎます。外部へのお知らせが必要なほど広範囲かどうかは、実際の症状と継続時間に基づき責任者が判断します。
EC・予約サービスは復旧確認にも操作テストが必要
ECや予約サービスでは、公開URLが200を返していてもカートや予約処理が失敗する場合があります。監視アラートが正常に戻っただけで、利用者の手続きが完了できると断定しないことが大切です。関連する機能を安全な方法で確認する手順を作っておきます。
テスト注文やテスト予約が必要な場合は、専用環境・検証用のデータを用意し、本番の売上・在庫・顧客通知に影響しないようにします。無断で本番操作を自動実行する監視設定は避けてください。
制作会社は顧客ごとの対応範囲を明確にする
複数の顧客サイトを保守する制作会社では、同じサーバーに複数サイトが乗っていて、一度の障害でアラートが多数発生する場合があります。サイトごとに同じ調査を繰り返さず、共通するサーバー・DNS・CDNなどの問題がないか整理することが役立ちます。
ただし顧客サイトの管理権限や保守契約は異なります。監視結果を共有すること、設定を変更すること、顧客へ報告することは別の権限です。契約範囲と承認を確認し、担当者を誤って割り当てないようにしましょう。
担当者が判断しやすいアラート文面の作り方
アラートの件名が「エラー発生」だけだと、何のサイトで何が起きたのか分かりません。通知内容は、受信した人がすぐに対象を特定し、必要な確認を始められることが目的です。通知を自動送信する機能の有無とは別に、管理表や運用マニュアルへ使える形式で整理します。
件名にはサイト名・重大度・症状を入れる
例えば「【緊急・要確認】採用サイトの応募入口でHTTP 503」のように、対象と事象がひと目で分かる構成が役立ちます。ただしチェックが一度失敗しただけなら、件名を「全システム停止」などと断定しないようにします。
同じアラートを複数のサービスから受ける運用では、サイト識別名や障害の種類を統一します。メール・チャット・チケットなどの通知経路を使う場合も、件名で判断できる情報の水準を揃えると確認漏れを減らしやすくなります。
本文には判定根拠と最初の確認先を記載する
実務で使う文面の例は「対象:採用サイト/URL:example.com/apply//検知:15:20 JST/確認結果:HTTP 503が連続/一次担当:Web運用/次の確認:公開URLの再確認とサーバー公式障害情報」です。これは説明用の例であり、実際にその障害が発生したという記録ではありません。
調査手順書のURLや障害管理番号があると、担当者が次の行動を取りやすくなります。Google Cloud Monitoringの公式ドキュメントでも、通知にトラブルシューティング情報や関連リンクを含める方法が案内されています。
原因が未確認なら断定しない
「HTTP接続が失敗した」ことと「サーバーが停止した」ことは同じではありません。DNS、通信経路、アクセス制限、監視側の問題など、原因は複数考えられます。事実は明確に伝え、原因は確認中と書く方が正確です。
同様に、復旧時は「15:45の外部チェックで正常応答を確認」という範囲にとどめます。未確認のログインやフォーム操作まで正常と断定しないことが、利用者や社内担当者の誤解を防ぎます。
夜間・重複・計画メンテナンス時の通知ルール
運用が始まると、同じ障害に対する大量のアラートや、予定された保守作業中の不要な通知が課題になります。こうした問題は単なる通知回数の調整だけでなく、誰がいつ確認できるかを含めて考えます。
複数アラートは同じ原因かどうかでまとめる
一つのサーバー障害で企業サイト・採用サイト・問い合わせ入口が同時に失敗すると、複数のアラートが発生する場合があります。担当者へ同じ原因の確認依頼を繰り返すと、復旧作業の妨げになります。関連するURLやサーバー単位で事象をまとめる考え方が役立ちます。
Grafana Alertingの公式資料では、アラートをラベルなどでグループ化し、関連する通知をまとめる方法が説明されています。ただし利用するサービスに同じグルーピング機能があるとは限りません。自動でまとめられない場合も、管理台帳で共通の障害番号を付けると整理できます。
夜間に誰も対応できない運用は無理に隠さない
小規模な運営体制では、すべてのWebサイトに24時間の有人対応を用意できるとは限りません。緊急の顧客手続きがあるサイトと、翌営業日の確認でも影響が限定的なサイトを区別し、必要な当番体制を検討します。
通知を夜間に抑制する場合でも、サイトの障害がなくなったわけではありません。夜間の失敗履歴を残し、翌営業日に何を確認するか決めておきましょう。夜間も事業に影響が大きいサイトなら、夜間対応できる体制が必要か責任者が判断します。
メンテナンス中は通知と計測の停止を区別する
予定されたメンテナンスで一時的にWebサイトを使えなくするなら、不要な緊急通知を抑える運用が考えられます。ただし通知を一時停止するのか、監視チェック自体を停止するのかでは、後から見られる記録が変わります。
GrafanaではSilencesやMute timingsなど通知を抑制する機能がありますが、サービスによって設定方法は異なります。保守開始と終了の時刻、担当者、復旧確認を記録し、作業後に通知抑制を解除し忘れないようにします。
通知未着の調査は別の運用課題
ここで扱うのは、どの条件で誰へ連絡するかという設計です。実際にメールやチャットが届かない原因、迷惑メール判定、API連携の失敗、通知権限などの技術的な切り分けは別の問題です。通知未着のトラブルが発生した場合は、利用する通知サービスの配送記録と設定を調べる必要があります。
連絡順が正しくても、担当者が確認しなければ対応は進みません。通知媒体の配送と、人が確認したことの両方を区別して検証してください。配信機能が存在しないサービスでは、手動で確認する運用に合わせて設計する必要があります。
アラート運用表を作るための項目と記入例
設計した内容は担当者の記憶に頼らず、誰が見ても分かる形に残します。最低限、対象、条件、重大度、最初の担当、連絡方法、確認期限、引継ぎ先、復旧条件をまとめると実務で再利用しやすくなります。
| 項目 | 記入例 | 意味・確認ポイント |
|---|---|---|
| 対象サイト・URL | 採用サイト・公開応募入口 | どの機能への影響を確認するか |
| アラート条件 | 定期チェックの継続失敗 | 何回の失敗で判定するかは利用サービスの仕様に依存 |
| 重大度 | 応募受付期間中は緊急 | 期間・影響に応じて変更 |
| 一次担当 | Web運用当番 | 確認する人を明確にする |
| 一次確認の目標 | 社内目標として10分 | 監視・配送・復旧の保証時間ではない |
| 二次担当 | 応募システム保守担当 | 権限が必要な調査・復旧を引き継ぐ |
| 復旧確認 | 公開URLと応募操作を別々に確認 | HTTP正常と業務の正常を区別 |
| 記録 | 検知・着手・引継ぎ・復旧の時刻 | 振り返りと改善に使用 |
連絡先は人名だけでなく役割で管理する
個人名だけでアラート運用表を作ると、担当者が異動・退職したときに機能しなくなることがあります。「一次:Web運用」「二次:インフラ担当」のように役割で整理し、実際に担当する人と代替担当者を定期的に更新します。
委託先が関わる場合、営業時間・契約上の対応時間・緊急時の問い合わせ窓口も確認します。誰にどの権限があるかを記録しておけば、異常発生時に勝手な設定変更や対外連絡を防ぎやすくなります。
同じサイトでも状況により重大度は変わる
採用の応募ページが受付期間中に停止した場合と、募集終了後の一時的な公開停止では影響が異なります。キャンペーン期間、決済を行う時間帯、問い合わせ件数などを踏まえ、必要な範囲で優先度を変更する設計が考えられます。
ただし重要な手続きが夜間にも発生するサイトで、「営業時間外だから必ず参考扱い」とするのは危険です。ユーザーがいつ利用するかを基準にし、例外を増やしすぎない分かりやすいルールにします。
確認期限と復旧目標は別の数字にする
一次担当がアラートを確認するまでの時間、技術担当者が調査に着手するまでの時間、実際に復旧するまでの時間は同じではありません。「10分以内に確認」という社内目標があっても、10分で原因を特定して復旧できると保証するものではありません。
記録にも検知、担当者確認、対応着手、復旧確認の時刻を分けて残しましょう。後から対応が遅れた場所を振り返ることができ、監視ツールの設定だけでは改善できない運用上の課題を見つける手掛かりになります。
アラート設計を公開前にテストする手順
運用表を作っただけでは、誰がどのように動くか分からないことがあります。実際のサイトを無断で停止させるのではなく、過去ログや模擬アラートを使って連絡手順と担当者の役割を確認します。
手順1:代表的な3パターンで通知条件を検証する
まず「一度だけ失敗して回復」「失敗が継続」「監視自体が実行されず結果がない」という3パターンを用意します。それぞれ重大度、記録する内容、誰が確認するか、次に調べることを整理します。
再試行と連続失敗の条件が監視ツールで設定できる場合は、テスト環境や記録済みデータで判定結果を確認します。そもそも対応していない機能を前提に運用表を作らないようにしましょう。
手順2:担当者が不在のケースを試す
一次担当が確認できないと仮定し、代替担当者の所在と連絡方法、引継ぎ情報を確認します。例えば当番表に担当がいるのに現在の連絡先が古いと、実際の障害時には連絡できません。役割と連絡先の更新作業も運用に含めます。
連絡テストを行う場合は、社内で承認された方法と時間帯で実施し、誤って本物の緊急事態と受け取られないよう事前に周知します。監視対象サイトへの負荷や外部顧客への通知が起きる試験を無断で実施してはいけません。
手順3:復旧判定と事象の記録を確認する
復旧の例として、公開URLへの応答が正常へ戻り、重要な利用者操作も確認できたという想定を使います。「誰が復旧を判断するか」「どこへ記録するか」「残る注意点があるか」を確認します。
監視ツールの復旧表示が出た段階で、自動的にすべての業務機能が正常だと判断しないことが大切です。ブラウザーやAPIの機能テストが必要な場合、運用表に確認担当を明記します。
手順4:通知件数だけでなく確認までの時間を振り返る
運用開始後は、緊急アラートの件数、確認が遅れた事例、二次担当への引継ぎ件数、重複した通知、不要な通知を調べます。アラート件数が少ないだけでは良い設計とは限りません。重要な障害を見逃していないか、一次担当が実際に動けているかも確認します。
Google SREやGrafanaの公式資料でも、通知が人の行動につながることや、重複通知の抑制が重要視されています。新しいサイトを追加したとき、担当者が変わったとき、重大な障害が起きた後には、運用表を見直しましょう。
エンリンクの管理画面内アラートで確認できること
エンリンクには、HTTP/HTTPSの定期監視、連続失敗による障害の可能性の記録、復旧・SSL期限などの履歴、管理画面内アラート、既読・未読管理が案内されています。一方で、一般的な監視ツールにある外部への自動送信や当番制のエスカレーションを、エンリンクで提供済みと書くことはできません。
監視結果・判定理由・管理画面内の情報を確認する
公式の機能一覧では、サイト別のHTTPステータスや応答時間、監視履歴、連続失敗による障害判定、管理画面内のアラートなどが説明されています。異常が記録された対象サイトの状況を確認し、履歴をたどって前後のチェック結果を比較する用途に利用できます。
連続失敗による判定が案内されていても、連続失敗回数やタイムアウト値を利用者が自由に設定できることまでは現行の公式説明から確認できません。この記事で示した詳細な通知設計は、エンリンクに限らない一般的な運用方法として説明しています。
既読・未読管理と対応着手は分けて考える
エンリンクの公開機能一覧では、管理画面のお知らせを既読にし、未読件数と履歴を整理できるとされています。ただし既読は「誰が障害の復旧を引き受けたか」「二次担当へ自動的に引き継いだか」を保証するものではありません。担当者・期限・作業状況は必要に応じて別の運用表で管理します。
現行の公開説明では、メール・Slackなどへの自動配信、電話呼び出し、勤務当番による自動エスカレーションをエンリンクが提供していることは確認できません。記事中の外部通知の例は、その機能を持つ一般的なシステムの説明です。
無料から監視記録を確認して運用ルールを整える
2026年10月23日時点の料金プランでは、無料プランは登録5サイトまで、定期監視は1日2回、有料プランは15分・5分・1分の最短監視間隔が案内されています。設定間隔は実際の検知時刻や確認までの時間を保証するものではありません。
まず登録サイトの監視履歴や管理画面内アラートを確認し、誰が日々確認し、異常時にどこへ連絡するかを運用表として整理することができます。エンリンクは5サイトまで無料登録できるため、無理のない規模から管理を始められます。現行機能にない自動連絡が必要なら、別の対応可能な仕組みや人による運用を検討してください。
Webサイト監視のアラート設定についてよくある質問
運用の開始時に迷いやすい通知条件と連絡順のポイントを、実際にどんな判断が必要かという観点から整理します。設定の名称や対応機能は監視サービスごとに異なるため、導入前に公式仕様を確認してください。
アラートは何回失敗したら通知するべきですか?
すべてのサイトに同じ回数を当てはめることはできません。単発失敗で要確認の記録を残し、継続失敗で緊急扱いにする考え方がありますが、重要な受付・決済への影響が疑われる場合は早い確認が必要なこともあります。再試行や連続失敗の具体的な設定可否はツールによります。
通知を最初に受けるのはWeb担当者とサーバー担当者のどちらですか?
最初に影響を確認できる担当者を一次担当にし、内部の調査や設定変更が必要な場合に権限のある担当者へ引き継ぐ方法が考えられます。運営規模や責任範囲によって正解は異なります。誰が当番か、一次確認で何をするかを明確にしてください。
夜間も必ず通知する必要がありますか?
サイトの重要度と実際の利用時間によります。夜間に購入・予約などが発生するサイトなら、夜間対応体制の検討が必要です。一方、夜間の有人対応がないサイトでは、どの記録を残して翌営業日に確認するかを決めます。通知を止めても障害が解消するわけではありません。
担当者が通知を見なかったときはどうすればよいですか?
あらかじめ定めた確認期限を過ぎても着手できない場合、二次担当者や責任者へ引き継ぐルールを設けます。ただしツールが自動的に次の担当者へ連絡できるかは製品ごとに異なります。手動運用の場合も誰が引き継ぎを実施するか決めてください。
復旧通知が出たら障害対応は終了ですか?
必ずしも終了ではありません。例えば指定URLのHTTP応答が正常になっても、フォーム送信やログインなどの業務機能が使えない場合があります。監視が復旧と判定した対象と、利用者が必要とする操作の両方を確認し、必要な記録を残してから対応を閉じます。
アラートが多すぎる場合は全部まとめてよいですか?
同じ障害が原因で複数URLに失敗が出た場合、関連づけて扱うと確認の負担が減ります。しかし独立した重大な障害までまとめて隠してしまうのは危険です。サイト・重大度・原因候補を見て適切にグループ化し、個別の監視記録も残しましょう。
エンリンクからメールやSlackでアラートを送れますか?
現行の公開機能一覧では管理画面内のアラートと既読・未読管理は確認できますが、メール・Slackへの自動送信機能は確認できません。自動エスカレーションがあると断定せず、公式の機能一覧と利用中の管理画面を確認してください。
まとめ:通知条件だけでなく連絡順と復旧確認まで決める
Webサイト監視のアラート設計では、異常の種類と判定条件を決めるだけでなく、緊急度、一次担当者、確認期限、二次担当者、復旧の確認方法をセットにします。「何が起きたか」と「誰が次に何をするか」が結びついていることが、実際に役立つアラートの条件です。
単発失敗や欠測を継続障害と混同せず、予定されたメンテナンス中の扱い、夜間対応、重複通知、担当者不在の引継ぎも整理しましょう。すべてのサイトに同じ秒数や連絡方法を押しつけず、利用者への影響と運用体制を基準に調整することが大切です。
エンリンクでは登録サイトのHTTP監視結果、管理画面内アラート、監視履歴などが案内されています。無料でサイト監視を始める場合も、まず「誰が管理画面の異常を確認するか」を決めておくと、取得した記録を実際の対応に結びつけやすくなります。
参照した一次資料:Google SRE「Monitoring Distributed Systems」、Google Cloud「Alerting overview」、Google Cloud「Annotate notifications」、Grafana「Notifications」、Prometheus「Alerting rules」、AWS「Missing data in alarms」(参照日:2026年10月23日)。